方差与标准差有什么区别?用完整算例一步步讲清
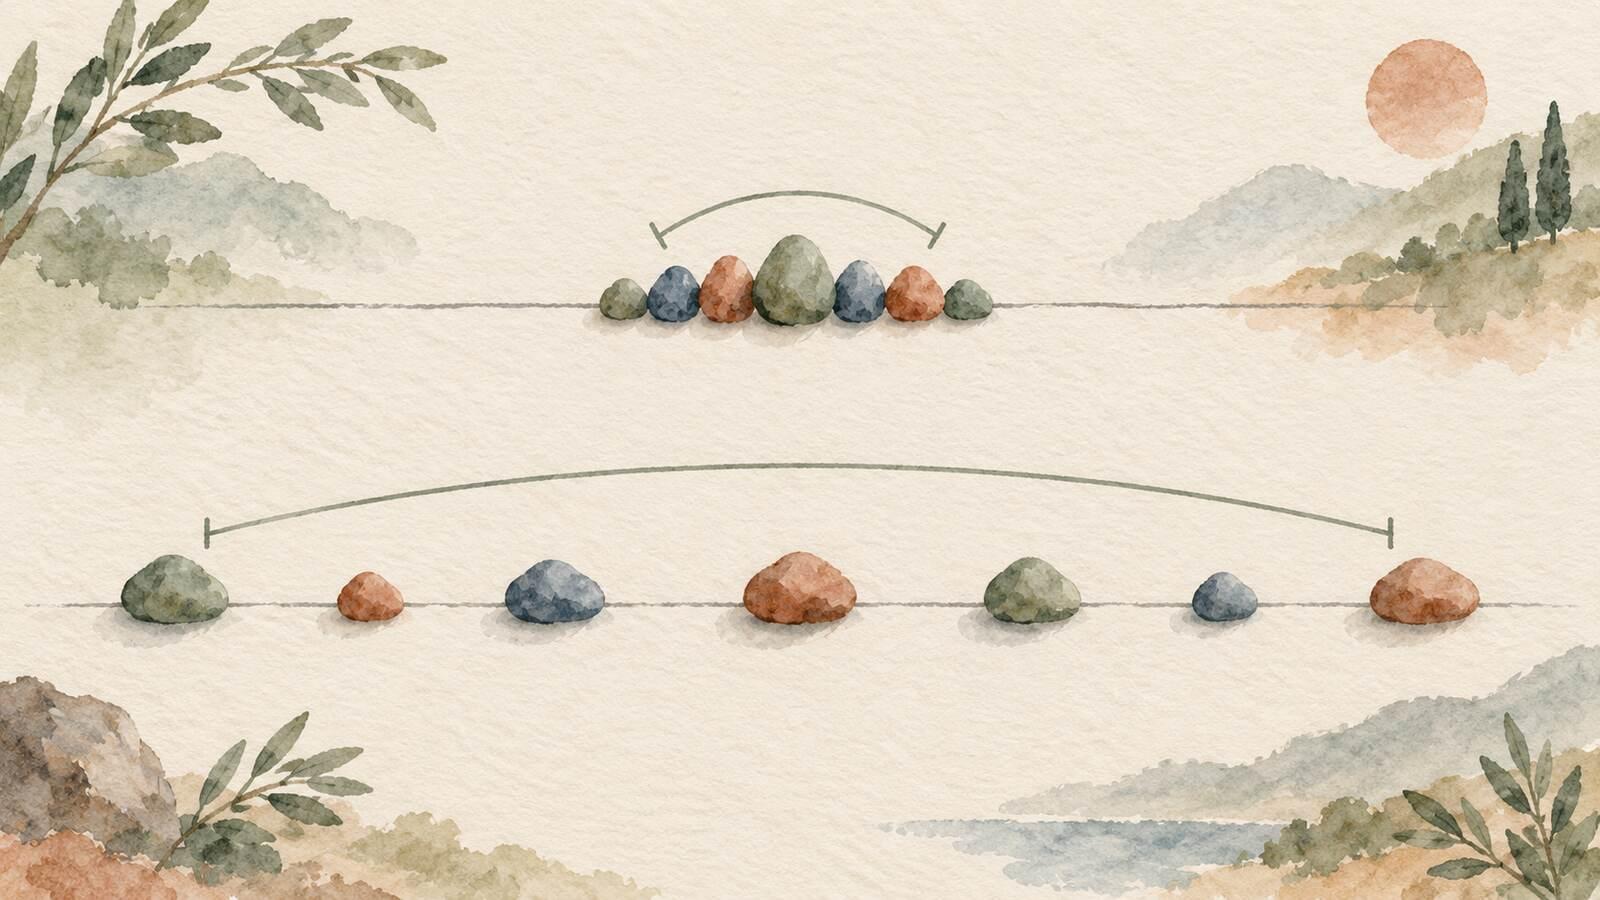
两组人拼拼图的平均时间都是4分钟。第一组每个人都用4分钟,第二组一半用2分钟,另一半用6分钟。平均数相同,第二组的完成时间却更分散。方差和标准差可以把这种差别量化。
它们测量的是同一件事:数据围绕均值的离散程度,但表示的尺度不同。方差使用原单位的平方,标准差再取平方根,回到原单位。如果数据单位是分钟,方差单位就是平方分钟,标准差仍是分钟。数据代表完整总体还是只代表一个样本,也会影响计算方法。
下面用同一组数据从头算到尾。如果想先了解均值、中位数与分布的整体概念,可以阅读统计学入门文章。
从每个数与均值的偏差开始
假设8次拼图尝试分别用了以下分钟数:
总时间是分钟,所以均值为分钟。接下来从每个时间中减去5,得到偏差:
负数表示比均值快,正数表示比均值慢。相对于算术均值的偏差总和必然是零。因此直接平均这些偏差,即使数据差距很大,也会得出零离散程度,毫无用处。将每个偏差平方后,结果不会为负,距离均值越远的值影响也越大。NIST关于离散程度指标的说明解释了这一点。
8个偏差的平方如下:
| 时间,分钟 | 与5分钟的偏差,分钟 | 偏差平方,分钟² |
|---|---|---|
| 2 | -3 | 9 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 5 | 0 | 0 |
| 5 | 0 | 0 |
| 7 | 2 | 4 |
| 9 | 4 | 16 |
最后一列相加为平方分钟。方差和标准差都从这个和出发。观察到的时间不会再变,接下来用什么数作分母,取决于这8次尝试代表什么。
如果它们是完整总体
假设这8次就是你关心的小比赛里的所有尝试。你描述的是这整个群体,而不是用它估计更大、没有观察到的群体。将平方偏差之和除以数据个数:
这就是总体方差,记作。然后开平方:
这就是总体标准差。开平方并没有把前面的计算变成绝对距离的平均数。它是在偏差已经平方并合并之后,恢复数值尺度和单位。OpenStax关于离散程度的章节使用相同的总体符号和分母。
这里的2分钟是什么意思?它以分钟为单位衡量完成时间围绕5分钟均值的分散程度。它不代表每个结果都在5分钟上下2分钟之内,因为列表里就有2分钟和9分钟。它也不意味着一定有某个固定比例的数据落在这个区间内。这样的百分比规则需要对分布作额外假设,光算出标准差还不够。
如果它们只是样本
现在假设同样的8个时间是从更大量的尝试中选出来的,你想估计那个更大总体的离散程度。观察到的均值5分钟也是从这份样本算出来的。通常的样本方差以为分母:
样本标准差为:
这个结果比总体算法稍大,因为同一个和除以7,而不是8。不是要在“宽松”和“严格”的公式之间选一个。两种算法回答的是不同问题:把这8个值当作完整群体来描述,还是用观察到的8个值估计更大群体的离散程度。OpenStax的数据科学教材列出了两种公式和单位的差别。
为什么是7?样本均值由这组观察值本身算出,会使样本内偏差看起来比相对于未知总体均值的偏差更小。在通常的抽样条件下,用可以校正估计方差时倾向于偏小的问题。一个记忆方法是:样本均值确定后,7个偏差可以自由变化,第8个必须让总和等于零。更深层的统计解释涉及反复抽样时样本方差的表现。这里最重要的实用规则是:先确认自己面对的是总体还是样本,然后再除。
应该报告哪个数字?
如果后续计算需要平方形式的离散程度,或者要代入以方差为定义的统计公式,就用方差。要让读者把离散程度与原始测量值比较,标准差更直观。“标准差约2.14分钟”可以直接与5分钟的均值相比;“方差约4.57平方分钟”虽然数学上正确,却不容易想象。
始终说明所用的是哪一种计算。“SD = 2”和“SD = 2.14”都来自同样的8个时间。若不标明总体或样本,读者无法知道结果为什么不同。如果计算器上有和,它们并不是可以互换的按钮。描述完整总体时选,计算样本时选。
单位也很重要。数据若以厘米为单位,方差用,标准差用厘米。数据若是没有单位的分数,两者也都没有单位。把两个数都叫作“分”或都叫作“平方分”,会掩盖开平方带来的变化。
为什么不用极差就好?
这组时间的极差是分钟。它只说明最大值与最小值相距多远,对中间6个数一无所知。保持2和9不变,只改一个中间值,极差仍是7,但整体形态已改变。方差与标准差使用每个观察值,所以中间值的变化也会影响结果。
这一优点也带来局限:平方会让远离均值的值产生相当大的影响。在例子里,仅9分钟那一次就贡献了平方分钟,而总和是平方分钟。如果大幅偏离确实重要,这很有用;但解释单个离散指标之前,你也应看看原始数据。NIST比较不同离散指标时,也指出大偏差影响更强。一个标准差数字不能代替你注意异常值或偏斜的分布。
为了建立直觉,比较两组各有4个值且均值都为4的数据:与。第一组每个平方偏差都是零,标准差也为零。第二组每个值距4都为2,所以每个平方偏差都是4。把两组分别视为完整总体,第二组方差为4、标准差为2。仅看相同的均值,完全看不出这个差别。
常见计算错误
还没确定数据代表什么就开始除。 在计算旁写下“总体”或“样本”。完整总体用;用样本估计总体方差的通常样本方差用。把两者混用,是两个看似正确的答案不一致的常见原因。
忘了开平方。 平方偏差之和除以分母,得到的是方差。标准差是该数的平方根。如果题目要求两者,就分别报告。
漏掉单位。 平方偏差之和与方差用平方单位,标准差用原始单位。这也是快速检查答案的方法。
把标准差叫作绝对距离的平均数。 那是另一个指标,平均绝对偏差。标准差先平方,再根据总体或样本选择分母,最后开平方。两种运算通常得出不同数字。
每一行都立即四舍五入。 尽可能保留精确的平方偏差和分数。对这组数据,直接从求样本标准差,比先把方差四舍五入后再开平方更准确。
不照抄表格,再练一遍
试试,先把这4个值当作完整总体。均值是,偏差为,平方偏差之和为。总体方差为平方单位,总体标准差为原始单位。如果这4个值改作样本,就除以3:样本方差为,样本标准差为。
只把最后一个值从5改成9。动手计算前,先预测离散程度会不会增加。答案是会,但仍要重新算一遍,因为均值也变了,不能只更新旧偏差表的一行。这是理解为什么均值与离散程度必须一起计算的练习。
能自己完成一张表后,可以去Math Zen的统计练习继续练习。尝试找出均值、选对分母,并检查答案的单位是否合理。如果样本与总体的区别仍很抽象,概率入门指南解释了为何可以利用样本思考更广的结果集合。
常见问题
方差总是比标准差大吗?
不是。两者单位不同,直接比较大小通常没有意义。只看数字时,如果在所选单位下方差小于1,它的平方根会比方差大;如果方差大于1,平方根反而更小。换一个单位就可能改变数字大小的比较,而数据本身没有变。
标准差会是负数吗?
不会。平方偏差非负,其和也非负,标准差所取的平方根同样非负。只有所有观察值相等时,标准差才是零。
什么时候用n-1?
用这组数据本身计算样本均值时,通常的样本方差与样本标准差使用。如果数据就是你要描述的完整总体,则用。使用计算器前先读清题目。
怎样最容易记住两者的区别?
方差通过偏差的平方衡量离散程度。标准差是这个方差的平方根,单位回到原数据。上面的例子从平方偏差总和平方分钟,得到总体方差平方分钟,再得到总体标准差分钟。
常见问题
- 方差和标准差有什么区别?
- 对总体而言,方差是各数据与均值之差的平方的平均数;对样本而言,通常将这些平方差之和除以n-1。标准差是相应方差的平方根,因此恢复到数据原本的单位。
- 样本方差为什么除以n-1?
- 样本均值也是用同一批数据估计的。用样本估计总体方差时,将平方偏差之和除以n-1,可以校正通常出现的向下偏差。如果数据是完整总体,则除以N。
- 标准差就是离均值距离的平均数吗?
- 不是。标准差要先把偏差平方,再用合适的分母相除,最后开平方。直接平均各绝对距离得到的是平均绝对偏差。两者都描述离散程度,但数值一般不同。