Variantie en standaardafwijking: een uitgewerkt voorbeeld
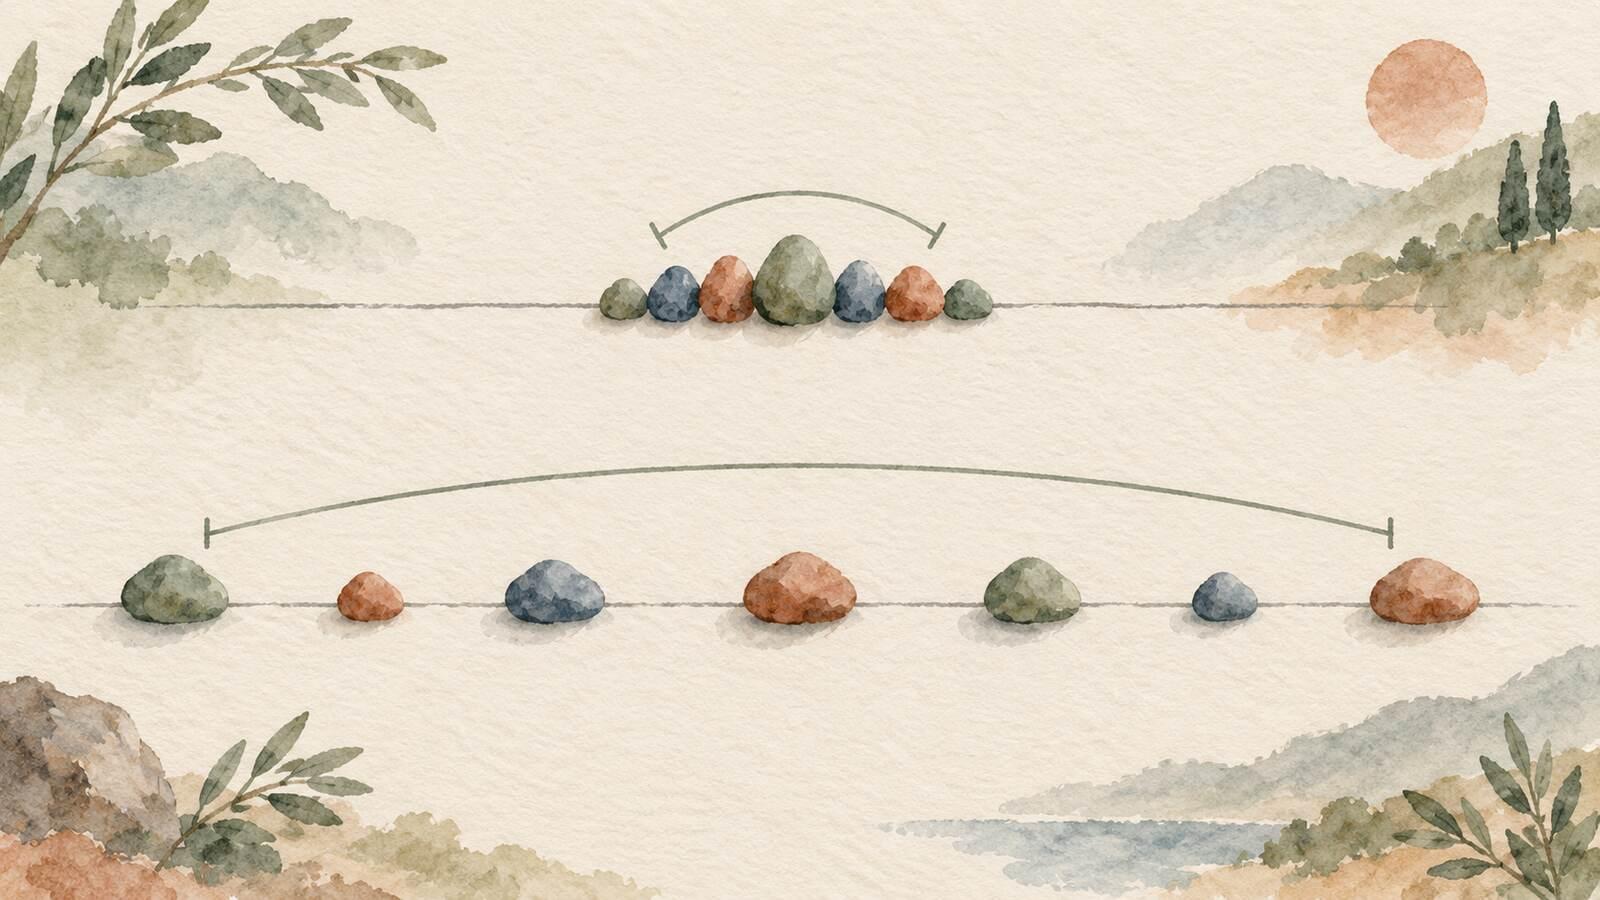
Twee groepen lossen een puzzel op in gemiddeld vier minuten. In de eerste groep is iedereen na vier minuten klaar. In de tweede is de helft na twee minuten klaar en de andere helft na zes. De gemiddelden zijn gelijk, maar de tijden van de tweede groep liggen verder uiteen. Variantie en standaardafwijking geven dat verschil een getal.
Ze meten dezelfde eigenschap, spreiding rond het gemiddelde, maar op verschillende schalen. Variantie gebruikt gekwadrateerde eenheden. De standaardafwijking neemt de vierkantswortel en keert terug naar de oorspronkelijke eenheid. Als de gegevens in minuten staan, is de variantie in minuten in het kwadraat en de standaardafwijking in minuten. De berekening verandert ook als je gegevens een hele populatie omvatten in plaats van alleen een steekproef.
Deze uitleg rekent één dataset van begin tot eind door. Heb je eerst meer overzicht nodig van gemiddelden, medianen en verdelingen, lees dan onze inleiding tot statistiek.
Begin bij afwijkingen van het gemiddelde
Stel dat acht pogingen om de puzzel op te lossen zoveel minuten duurden:
Samen zijn dat minuten, dus het gemiddelde is minuten. Trek nu van elke tijd vijf af. De afwijkingen zijn:
Een negatieve afwijking betekent sneller dan het gemiddelde; een positieve betekent langzamer. De afwijkingen tellen op tot nul, zoals afwijkingen van een rekenkundig gemiddelde altijd doen. Ze simpelweg middelen zou daarom nul spreiding opleveren, zelfs als de waarden sterk verschillen. Daar heb je niets aan. Door elke afwijking te kwadrateren wordt zij niet-negatief en krijgen grotere uitschieters meer invloed, zoals de NIST-uitleg over spreidingsmaten beschrijft.
Dit zijn de acht gekwadrateerde afwijkingen:
| Tijd, minuten | Afwijking van 5, minuten | Gekwadrateerde afwijking, minuten² |
|---|---|---|
| 2 | -3 | 9 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 5 | 0 | 0 |
| 5 | 0 | 0 |
| 7 | 2 | 4 |
| 9 | 4 | 16 |
De laatste kolom telt op tot minuten in het kwadraat. Die som is de basis van beide maten. Aan de geobserveerde tijden verandert vanaf nu niets. De noemer hangt af van wat die acht tijden voorstellen.
Als dit de hele populatie is
Stel je voor dat de acht pogingen alle pogingen zijn in de kleine wedstrijd die je wilt onderzoeken. Je beschrijft die complete groep en schat geen grotere, onzichtbare groep. Deel de som van de gekwadrateerde afwijkingen door het aantal waarden, :
Dat is de populatievariantie, met symbool . Neem vervolgens de vierkantswortel:
Dat is de populatiestandaardafwijking. De wortel maakt de berekening niet ongedaan en geeft ook niet de gemiddelde absolute afstand. Zij brengt de eenheden en schaal terug nadat de afwijkingen al zijn gekwadrateerd en samengevoegd. Het OpenStax-gedeelte over spreiding gebruikt dezelfde populatiesymbolen en noemer.
Wat betekenen die twee minuten hier? Het is een maat voor hoe de tijden rond het gemiddelde van vijf minuten liggen, uitgedrukt in minuten. Het zegt niet dat elk resultaat binnen twee minuten van vijf valt: in de lijst staan ook twee en negen. Evenmin volgt dat een bepaald percentage binnen die band moet vallen. Zulke percentageregels vragen aannames over de verdeling, niet alleen een berekende standaardafwijking.
Als dit een steekproef is
Stel nu dat diezelfde acht tijden gekozen zijn uit veel meer pogingen en dat je wilt schatten hoe sterk de grotere populatie varieert. Ook het geobserveerde gemiddelde van vijf is uit de steekproef berekend. De gebruikelijke steekproefvariantie gebruikt als noemer:
De steekproefstandaardafwijking is:
De uitkomst is iets groter dan bij de populatieberekening, omdat dezelfde som, , door zeven wordt gedeeld in plaats van door acht. Dit is geen keuze tussen een gulle en een strenge formule. Het zijn antwoorden op twee verschillende vragen: beschrijf alle acht waarden als complete groep, of gebruik acht geobserveerde waarden om de spreiding van een grotere groep te schatten. De data-science-tekst van OpenStax toont beide formules en het verschil in eenheden.
Waarom zeven? Het steekproefgemiddelde wordt aan dezezelfde observaties aangepast. Daardoor lijken de afwijkingen ervan meestal kleiner dan de afwijkingen van het onbekende populatiegemiddelde. corrigeert onder de gebruikelijke steekproefvoorwaarden die neerwaartse vertekening van de variantie. Een ezelsbruggetje: zodra het steekproefgemiddelde vastligt, kunnen zeven afwijkingen vrij variëren; de achtste moet hun som op nul brengen. De diepere statistische reden gaat over het gedrag van steekproefvariantie bij herhaalde steekproeven. Hier volstaat de praktische regel: bepaal vóór het delen of je een populatie of steekproef hebt.
Welk getal moet je rapporteren?
Gebruik variantie als een berekening om gekwadrateerde spreiding vraagt of als je verder rekent met een statistische formule die in variantie is uitgedrukt. Gebruik de standaardafwijking als lezers de spreiding met de oorspronkelijke metingen moeten kunnen vergelijken. ‘Een standaardafwijking van ongeveer 2.14 minuten’ is meteen te vergelijken met een gemiddelde van vijf minuten; ‘een variantie van ongeveer 4.57 vierkante minuten’ is wiskundig exact, maar lastiger voor te stellen.
Vermeld altijd de gekozen conventie. ‘SD = 2’ en ‘SD = 2.14’ komen allebei uit dezelfde acht tijden. Zonder het label populatie of steekproef kan een lezer niet zien waarom ze verschillen. Als je rekenmachine en aanbiedt, zijn dat geen uitwisselbare knoppen. Kies voor een beschrijving van de complete populatie en voor een steekproefberekening.
Ook de eenheid telt. Als de waarden in centimeters staan, gebruikt de variantie en de standaardafwijking centimeters. Zijn het eenheidsloze scores, dan zijn beide uitkomsten eenheidsloos. Beide getallen ‘punten’ of juist allebei ‘vierkante punten’ noemen verhult wat de wortel deed.
Waarom niet alleen de spreidingsbreedte gebruiken?
De spreidingsbreedte van onze tijden is minuten. Zij vertelt je de afstand tussen de uitersten en niets over de zes tussenliggende waarden. Verander een waarde in het midden terwijl twee en negen blijven staan; de spreidingsbreedte blijft zeven, hoewel het hele patroon verandert. Variantie en standaardafwijking gebruiken elke observatie, zodat zulke veranderingen wel meetellen.
Dit voordeel heeft een beperking: kwadrateren geeft verafgelegen waarden veel invloed. In de uitgewerkte data draagt de poging van negen minuten in haar eentje van de vierkante minuten bij. Dat is nuttig als een grote afwijking ertoe doet, maar betekent ook dat je de gegevens moet bekijken voordat je één spreidingsgetal interpreteert. NIST wijst bij de vergelijking van spreidingsmaten op dit sterkere effect van grote afwijkingen. Een standaardafwijking vervangt het opmerken van een ongebruikelijke waarde of scheve verdeling niet.
Vergelijk voor je gevoel twee reeksen van vier waarden met beide gemiddelde vier: en . De eerste heeft alleen gekwadrateerde afwijkingen van nul en dus standaardafwijking nul. In de tweede ligt elke waarde twee eenheden van vier, waardoor elke gekwadrateerde afwijking vier is. Behandel je beide reeksen als complete populaties, dan is de variantie van de tweede vier en haar standaardafwijking twee. Het gedeelde gemiddelde miste het hele verschil.
Veelgemaakte rekenfouten
Delen voordat je bepaalt wat de gegevens voorstellen. Schrijf ‘populatie’ of ‘steekproef’ boven de berekening. Voor een populatie gebruik je ; voor de steekproefvariantie waarmee je een populatie schat gebruik je . Die verwisseling is de meest voorkomende reden waarom twee ogenschijnlijk correcte antwoorden verschillen.
De wortel vergeten. De som gedeeld door de noemer is de variantie. De standaardafwijking is de wortel uit dat getal. Rapporteer beide als de opgave beide vraagt.
Eenheden weglaten. De som van gekwadrateerde afwijkingen en de variantie hebben gekwadrateerde eenheden; de standaardafwijking heeft de oorspronkelijke eenheid. Zo kun je je werk snel controleren.
Het de gemiddelde absolute afstand noemen. Dat is een andere maat, de gemiddelde absolute afwijking. Voor standaardafwijking kwadrateer je eerst, neem je dan het gemiddelde volgens de populatie- of steekproefregel en trek je daarna de wortel. Die bewerkingen geven doorgaans een ander getal.
Elke rij afronden. Houd de gekwadrateerde afwijkingen en exacte breuk zo lang mogelijk aan. Met deze gegevens levert een nauwkeuriger steekproefstandaardafwijking op dan een wortel uit een al afgeronde variantie.
Oefen zonder de tabel over te nemen
Probeer en behandel deze vier waarden als complete populatie. Het gemiddelde is . De afwijkingen zijn , dus de som van hun kwadraten is . De populatievariantie is vierkante eenheden en de populatiestandaardafwijking is eenheden. Als de vier waarden juist een steekproef vormen, deel je door drie: steekproefvariantie en steekproefstandaardafwijking .
Verander alleen de laatste waarde van vijf in negen. Voorspel vóór het rekenen of de spreiding zal toenemen. Dat zal zo zijn, maar reken alles opnieuw: ook het gemiddelde is veranderd, dus je kunt niet alleen één rij van de oude tabel met afwijkingen aanpassen. Dit is een goede oefening om te zien waarom gemiddelde en spreiding samen berekend moeten worden.
De statistiekoefeningen van Math Zen zijn nuttig zodra je één tabel met de hand kunt invullen. Oefen het vinden van het gemiddelde, het kiezen van de juiste noemer en het controleren of de eenheden van je antwoord kloppen. Voelt het verschil tussen steekproef en populatie nog abstract, dan legt onze kansrekeninggids uit waarom een steekproef helpt bij redeneren over een grotere verzameling uitkomsten.
Veelgestelde vragen
Is variantie altijd groter dan standaardafwijking?
Nee. Ze hebben verschillende eenheden, dus een directe vergelijking van groter of kleiner is meestal betekenisloos. Getalsmatig is bij een variantie onder één in een gekozen eenheid de wortel groter dan de variantie; boven één is de wortel kleiner. Door de eenheid te veranderen kan die numerieke vergelijking omslaan zonder dat de gegevens veranderen.
Kan standaardafwijking negatief zijn?
Nee. Gekwadrateerde afwijkingen zijn niet-negatief, hun som ook, en de wortel voor standaardafwijking eveneens. Zij is alleen nul als alle geobserveerde waarden gelijk zijn.
Wanneer gebruik ik n min 1?
Gebruik voor de gebruikelijke steekproefvariantie en steekproefstandaardafwijking wanneer je het steekproefgemiddelde uit diezelfde gegevens berekent. Gebruik als de gegevens de hele populatie vormen die je wilt beschrijven. Lees de opgave voordat je de rekenmachine gebruikt.
Wat is de eenvoudigste manier om het verschil te onthouden?
Variantie meet spreiding via gekwadrateerde afwijkingen. Standaardafwijking is de wortel uit die variantie, terug in de oorspronkelijke eenheid van de gegevens. Het voorbeeld gaat van in totaal vierkante minuten naar vierkante minuten populatievariantie en ten slotte minuten populatiestandaardafwijking.
Veelgestelde vragen
- Wat is het verschil tussen variantie en standaardafwijking?
- Voor een populatie is de variantie het gemiddelde van de gekwadrateerde afwijkingen van het gemiddelde; bij een steekproef deel je de som van die afwijkingen door n min 1. De standaardafwijking is de wortel uit de bijbehorende variantie en heeft dus de oorspronkelijke eenheid van de gegevens.
- Waarom deel je de steekproefvariantie door n min 1?
- Het steekproefgemiddelde wordt uit dezelfde gegevens geschat. Delen van de som van gekwadrateerde afwijkingen door n min 1 corrigeert de gebruikelijke onderschatting als je met die steekproef de populatievariantie schat. Voor een volledige populatie deel je door N.
- Is de standaardafwijking de gemiddelde afstand tot het gemiddelde?
- Nee. Je kwadrateert afwijkingen, neemt het gemiddelde met de juiste noemer en trekt daar de wortel uit. De gemiddelde absolute afwijking middelt in plaats daarvan de absolute afstanden. Beide meten spreiding, maar leveren verschillende getallen op.