Statistiek intuïtief begrijpen (wat "gemiddelde" verbergt)
Statistiek is de wiskunde van verstand maken van data, van een betrouwbaar signaal trekken uit een stapel getallen die variëren. Ze doet twee banen: ze vat samen wat je al hebt (een klas toetscijfers, een maand verkopen) en ze laat je redeneren over wat je niet volledig kunt zien (de meningen van een heel land uit een peiling van duizend mensen). Dit artikel bouwt beide ideeën vanaf nul, en laat daarna zien waar de bekende termen (gemiddelde, mediaan, standaardafwijking, de klokkromme) écht vandaan komen.
Statistiek heeft een reputatieprobleem. Veel leerlingen ontmoeten haar als een zak formules om te onthouden: deze voor variantie, die voor de standaardfout, een derde voor de correlatiecoëfficiënt. De formules worden toegepast, de antwoorden worden uitgerekend, en de betekenis komt nooit aan.
Laten we dat fiksen.
Twee banen, niet één
Alles in een inleidende statistiekcursus valt in een van twee emmers.
Beschrijvende statistiek vat data samen die je hebt. Als je de lengte van elke leerling op een school hebt gemeten, kookt beschrijvende statistiek die honderden getallen terug tot een paar die de essentie vangen: een typische lengte, hoeveel lengtes variëren, hoe de vorm van de verdeling eruitziet.
Inductieve statistiek redeneert over data die je niet hebt. Je kunt niet de lengte van elke volwassene op aarde meten, dus je meet een steekproef en leidt iets af over iedereen. Hier leven peilingen, medische trials en kwaliteitscontrole. Het is de krachtigere helft, en ze rust volledig op de beschrijvende helft.
Bijna elke verwarring in statistiek klaart op zodra je vraagt: beschrijf ik wat ik heb, of leid ik af over wat ik niet heb? Begin met beschrijven.
Het centrum: waar de data zit
De eerste vraag over elke dataset is "wat is een typische waarde?" Er zijn drie eerlijke antwoorden, en ze zijn het expres oneens.
Het gemiddelde is wat de meeste mensen het gemiddelde noemen: tel alles op, deel door het aantal. Het gebruikt elke waarde, dat is zijn sterkte en zijn zwakte.
De mediaan is de middelste waarde zodra je de data sorteert. De helft van de waarden zit erboven, de helft eronder. Ze negeert hoe extreem de extremen zijn en let alleen op positie.
De modus is de waarde die het vaakst opduikt. Het is de enige die werkt voor dingen die je niet kunt middelen, zoals de meest verkochte schoenmaat.
Bij symmetrische data landen alle drie grofweg op dezelfde plek, en het onderscheid voelt academisch. Het onderscheid stopt academisch te zijn zodra de data scheef is.
Stel je een kamer voor met negen schoolmeesters en één miljardair. Het mediane inkomen beschrijft een gewone leraar, omdat de middelste persoon een leraar is. Het gemiddelde inkomen ligt in de tientallen miljoenen, omdat de miljardair het omhoog sleept. Beide getallen zijn correct. Slechts één is eerlijk over een typisch persoon in de kamer.
Dit is de allerbelangrijkste gewoonte bij het lezen van statistiek: wanneer iemand een "gemiddelde" meldt, vraag of het een rekenkundig gemiddelde of een mediaan is, en vraag of de data scheef is. Inkomens, huizenprijzen, wachttijden en weergavetellingen zijn bijna altijd scheef, en het gemiddelde vleit ze bijna altijd.
De spreiding: waarom het centrum niet genoeg is
Twee datasets kunnen exact hetzelfde gemiddelde delen en totaal niet op elkaar lijken.
Cijfers klas A: 70, 72, 70, 68, 70. Gemiddelde: 70. Cijfers klas B: 40, 95, 100, 50, 65. Gemiddelde: 70.
Zelfde gemiddelde, compleet verschillende verhalen. Klas A is consistent. Klas B is chaotisch. Het gemiddelde alleen kan ze niet uit elkaar houden, dus we hebben een getal voor spreiding nodig.
De ruwe versie is het bereik, de grootste waarde minus de kleinste. Het is makkelijk maar breekbaar, omdat het van maar twee getallen afhangt en één uitschieter het slopen.
De serieuze versie is de standaardafwijking, en het idee erachter is eenvoudiger dan de formule suggereert. Vraag: gemiddeld, hoe ver is elke waarde van het gemiddelde? Meet de afstand van elke waarde tot het gemiddelde, en neem dan een soort gemiddelde van die afstanden. Een kleine standaardafwijking betekent dat alles bij het centrum samenklit (klas A). Een grote betekent dat waarden ver en wijd liggen (klas B).
De reden dat de formule de afstanden kwadrateert en daarna aan het eind een wortel neemt (in plaats van alleen de ruwe afstanden te middelen) is vooral zodat positieve en negatieve gaten elkaar niet opheffen, en zodat grotere afwijkingen zwaarder tellen. Maar de betekenis verandert nooit: standaardafwijking is de typische afstand tot het gemiddelde, gerapporteerd in dezelfde eenheden als de data. Als toetscijfers een standaardafwijking van 8 punten hebben, dan is "plus of min 8 punten" je gevoel van hoeveel cijfers zwerven.
Het gemiddelde vertelt je waar. De standaardafwijking vertelt je hoeveel je "waar" kunt vertrouwen om één enkel geval te beschrijven.
De vorm: de klokkromme en waarom ze overal is
Zodra je centrum en spreiding hebt, is de natuurlijke volgende vraag de overall vorm van de data. Zet uit hoe vaak elke waarde voorkomt en je krijgt een verdeling.
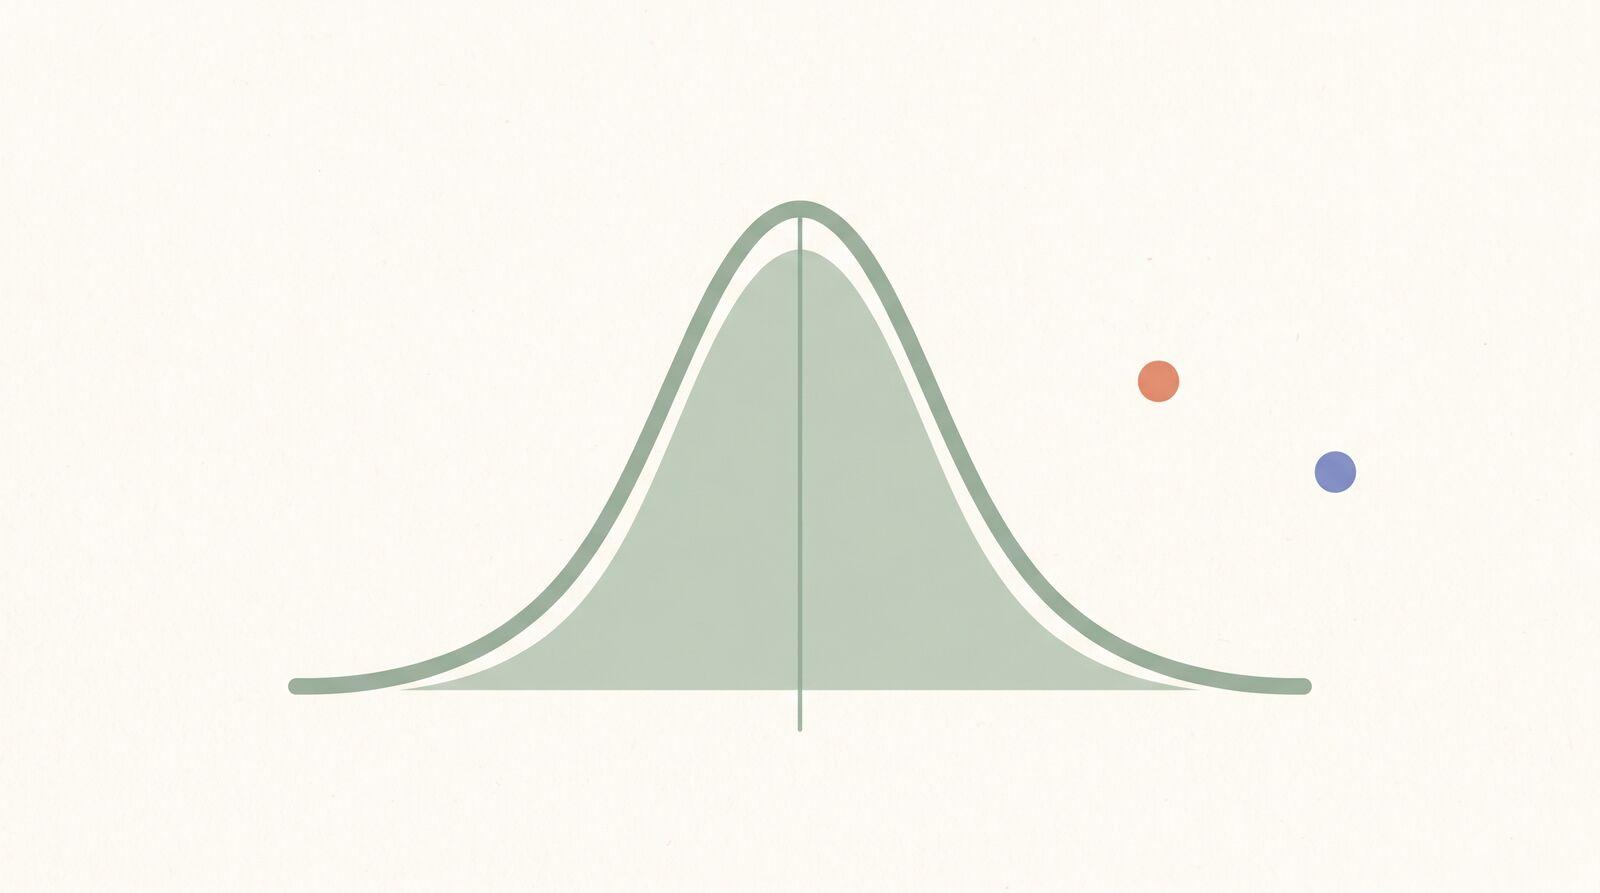
De beroemdste vorm is de normale verdeling, de klokkromme: symmetrisch, met de meeste waarden bij het gemiddelde gebundeld en steeds minder naarmate je naar de extremen gaat. Lengtes, meetfouten, en veel natuurlijke grootheden volgen haar nauw.
De klokkromme duikt zo vaak op om een diepe reden. Wanneer een grootheid de som is van veel kleine onafhankelijke invloeden (je lengte is genen plus voeding plus slaap plus honderd andere duwtjes), neigt het resultaat naar een klokkromme, bijna ongeacht hoe elke afzonderlijke invloed zich gedraagt. Dat is het ruwe idee achter een van de belangrijkste resultaten in de hele statistiek, de centrale limietstelling, en het is waarom de normale verdeling het standaarddecor is voor zoveel inductie.
De klokkromme geeft de standaardafwijking ook een concreet rendement. Bij normale data valt ongeveer 68 procent van de waarden binnen één standaardafwijking van het gemiddelde, ongeveer 95 procent binnen twee, en ongeveer 99,7 procent binnen drie. Dus als volwassen lengtes een gemiddelde van 170 cm hebben en een standaardafwijking van 7 cm, valt grofweg 95 procent van de mensen tussen 156 en 184 cm. Het spreidingsgetal stopt abstract te zijn en begint te voorspellen waar dingen écht landen.
Correlatie is geen causaliteit
Wanneer twee grootheden samen bewegen, zeggen we dat ze gecorreleerd zijn. Langere mensen wegen vaak meer: lengte en gewicht zijn positief gecorreleerd. Als de ene omhoog gaat, gaat de andere mee.
De val is correlatie behandelen als bewijs van oorzaak. IJsverkoop en verdrinkingsdoden stijgen elke zomer samen. IJs veroorzaakt geen verdrinking. Een verborgen derde factor, warm weer, drijft beide. Dit is een confounder, en het is de reden dat correlatie alleen nooit causaliteit vaststelt.
Correlatie is een echte aanwijzing. Ze vertelt je waar te kijken. Maar om te beweren dat A B veroorzaakt, heb je meer nodig: een gecontroleerd experiment, een plausibel mechanisme, en het uitschakelen van confounders. De koppen die aankondigen "mensen die X doen leven langer" rusten bijna altijd op correlatie, en reiken bijna altijd te ver. Dat sceptisch lezen is een van de nuttigste dingen die statistiek leert.
Inductie: hoe weinigen voor velen spreken
Nu de krachtige helft. Een landelijke peiling van 1.000 mensen beweert 300 miljoen te vertegenwoordigen. Hoe is dat niet absurd?
Het kerninzicht is dat toeval in bulk voorspelbaar is. Als je steekproef écht willekeurig en representatief is, vertelt de wiskunde van de kansrekening je hoe ver je schatting waarschijnlijk ernaast zit. Die onzekerheid wordt gerapporteerd als een foutmarge: "52 procent, plus of min 3 punten" betekent dat het ware cijfer zeer waarschijnlijk tussen 49 en 55 procent ligt.
Twee dingen bepalen of je een inductie kunt vertrouwen:
- Steekproefomvang beheerst toevalsruis. Grotere steekproeven geven smallere foutmarges, al met afnemende meeropbrengst: de fout halveren kost grofweg vier keer de steekproef.
- Steekproefkwaliteit beheerst vertekening, en vertekening is het dodelijkere probleem. Een peiling van een miljoen mensen die allemaal dezelfde website bezoeken vertelt je over die website, niet over het land. Geen steekproefomvang fikt een steekproef die systematisch mensen uitsluit. Representativiteit komt eerst; omvang scherpt alleen een al eerlijke steekproef.
Daarom is de vraag bij elke statistiek niet alleen "hoe groot was het onderzoek" maar "wie zat er écht in, en wie is buitengebleven."
Veelvoorkomende vallen om op te letten
Statistiek is eerlijk. De manier waarop ze gerapporteerd wordt vaak niet. Een paar patronen om te vangen:
- Het weggemiddelde gemiddelde. "De gemiddelde klanttevredenheid is hoog" kan een gesplitst publiek van zeer blije en zeer boze klanten verbergen, met bijna niemand in het midden. Vraag altijd naar spreiding, niet alleen centrum.
- De afgekapte as. Een staafdiagram waarvan de verticale as bij 90 begint in plaats van 0, maakt van een minuscuul verschil een dramatische klif. De getallen zijn écht; het plaatje liegt.
- De ontbrekende noemer. "Gevallen verdubbeld" is betekenisloos zonder te weten of dat van twee naar vier is of van twee miljoen naar vier miljoen. Een procentuele verandering is alleen zo zinvol als de basis waartegen ze gemeten wordt.
- Uitgekozen eindpunten. Kies de juiste start- en einddata en bijna elke trend kan omhoog of omlaag wijzen.
Hoe dit met de rest van de wiskunde samenhangt
Statistiek staat niet alleen. Ze zit bovenop ideeën die je misschien al hebt ontmoet. Ze is gebouwd van kansrekening, die de regels levert voor hoe willekeurige steekproeven zich gedragen en waar foutmarges vandaan komen. Ze leunt op percentages en verhoudingen voor bijna elk resultaat dat ze meldt. En de gladde krommen waarop ze rust, de oppervlakte-onder-de-klokkromme-berekeningen die een verdeling in een kans omzetten, zijn dezelfde integratie-ideeën uit de calculus, toegepast op data.
Wanneer je statistiek oefent in Math Zen, lopen de opgaven van beschrijvende maten (gemiddelden, medianen en standaardafwijkingen berekenen en vergelijken) naar verdelingen lezen en redeneren over steekproeven. Ze met de hand uitwerken, in plaats van een rekenmachine een getal te laten spuwen, is wat het instinct bouwt om de juiste vraag te stellen: is dit centrum eerlijk, is deze spreiding klein genoeg om te vertrouwen, vertelt deze correlatie me écht iets? Die probleemtypes in de tijd mengen, met de gespreide herhaling die in de oefenstroom is ingebouwd, is wat de intuïtie laat blijven hangen in plaats van na de toets te vervagen.
De conclusie
Statistiek is twee banen: de data beschrijven die je hebt en afleiden over de data die je niet hebt. Beschrijven heeft drie getallen nodig, een centrum (gemiddelde of mediaan, en de keuze telt wanneer data scheef is), een spreiding (standaardafwijking, de typische afstand tot het centrum), en een vorm (vaak de klokkromme). Afleiden heeft een steekproef nodig die eerst representatief is en daarna groot, en een eerlijke foutmarge.
De volgende keer dat je een statistiek ziet, lees dan niet alleen het getal. Vraag: gemiddelde of mediaan? Hoeveel spreiding? Wie zat in de steekproef? Correlatie of oorzaak? Die vier vragen maken van statistiek van een muur formules een gereedschap om niet voor de gek gehouden te worden.
Veelgestelde vragen
- Wat is het verschil tussen gemiddelde, mediaan en modus?
- Het gemiddelde is het rekenkundig gemiddelde, de som van alle waarden gedeeld door hoeveel het er zijn. De mediaan is de middelste waarde wanneer de data gesorteerd is, met de helft erboven en de helft eronder. De modus is de waarde die het vaakst voorkomt. Ze komen overeen bij symmetrische data maar trekken uit elkaar wanneer de data scheef is, en precies dan telt de keuze.
- Wanneer moet ik de mediaan gebruiken in plaats van het gemiddelde?
- Gebruik de mediaan wanneer een paar extreme waarden het gemiddelde ergens onrepresentatiefs naartoe zouden slepen. Inkomens, huizenprijzen en reactietijden zijn klassieke gevallen. Eén miljardair in een kamer vol leraren maakt het gemiddelde inkomen misleidend, maar de mediaan beschrijft nog steeds een typisch persoon in de kamer.
- Wat meet de standaardafwijking écht?
- De standaardafwijking meet hoe gespreid de data rond het gemiddelde is, in dezelfde eenheden als de data zelf. Een kleine standaardafwijking betekent dat waarden strak rond het gemiddelde clusteren. Een grote betekent dat ze wijd uiteen liggen. Ze beantwoordt de vraag die het gemiddelde niet kan: hoe typisch is typisch.
- Wat is het verschil tussen correlatie en causaliteit?
- Correlatie betekent dat twee dingen de neiging hebben samen te bewegen. Causaliteit betekent dat het ene het andere écht laat gebeuren. IJsverkoop en verdrinking stijgen samen, maar geen van beide veroorzaakt de andere: zomerhitte drijft beide. Correlatie is een aanwijzing die onderzoek waard is, nooit bewijs op zichzelf.
- Waarom is een grotere steekproef beter?
- Grotere steekproeven krimpen toevalsruis, zodat het resultaat waarschijnlijker de echte populatie weerspiegelt. Het addertje: grootte kan een vertekende steekproef niet fiksen. Een peiling van een miljoen mensen die allemaal dezelfde website lezen is nog steeds scheef. Representativiteit telt meer dan ruwe omvang, en pas daarna scherpt omvang de schatting.