Kansrekening intuïtief begrijpen (waarom "1 op de miljoen" je voor de gek houdt)
De weersverwachting zegt 30 procent kans op regen. Een medische test op een zeldzame ziekte komt positief terug. De loterijjackpot staat op 200 miljoen euro en je collega koopt een stapel lootjes. In elk van deze situaties heeft je onderbuik een mening, en je onderbuik heeft het meestal mis. Kansrekening is de plek waar wiskundige intuïtie de meeste mensen het vaakst in de steek laat, zelfs slimme mensen, zelfs mensen die het vak onderwijzen. De getallen zijn niet moeilijk. De instincten eromheen zijn misleidend.
Dit artikel is het beeld van wat een kans écht is, waarom vertrouwde intuïties breken, en hoe je ze herstelt. De wiskunde is eenvoudig. De denkomslag is het lastigere deel, en die loont in bijna elk domein dat een mens ooit raakt: weer, geneeskunde, sport, financiën, gokken, machine learning, zelfs gewone risicobeslissingen over vliegen versus autorijden.
Het ene idee: tellen
Strip al het andere weg, en kansrekening is tellen. Om de kans op een gebeurtenis te vinden, tel je de uitkomsten waarbij de gebeurtenis plaatsvindt, en deel je door het totale aantal uitkomsten waarmee je begon. Dat is de hele definitie. Elke formule in het hoofdstuk is een zorgvuldige manier om te tellen.
Gooi een eerlijke zeszijdige dobbelsteen. De kans op een 4 is één uitkomst (een 4) gedeeld door zes uitkomsten in totaal (1 tot en met 6), dat is 1/6. De kans op een even getal is drie uitkomsten (2, 4, 6) gedeeld door zes in totaal, dat is 3/6, of 1/2. De kans op een getal groter dan 7 is nul uitkomsten gedeeld door zes, dat is 0, omdat zo'n uitkomst niet bestaat.
Als het beeld klinkt als breuken, dan is dat omdat het dat is. Zoals we in het artikel over breuken lieten zien, is een breuk een deling die staat te wachten. Kansrekening is precies datzelfde idee, toegepast op uitkomsten: de passende over het geheel. Het hele vak is tot op de bodem breuken.
De catch is dat "uitkomsten tellen" moeilijker wordt naarmate de situaties ingewikkelder worden. De rest van het hoofdstuk, permutaties, combinaties, voorwaardelijke kans, de stelling van Bayes, is alleen zorgvuldig boekhouden over hoe je goed telt wanneer de situatie niet zo eenvoudig is als een dobbelsteen.
Onafhankelijke gebeurtenissen: wanneer kansen vermenigvuldigen
Stel je gooit twee keer een eerlijke munt. Wat is de kans op twee keer kop achter elkaar?
Veel mensen gokken 1/2 plus 1/2, dat is 1, en dat kan duidelijk niet kloppen. Sommigen antwoorden 1/2, wat veiliger voelt maar ook fout is. Het juiste antwoord is 1/2 keer 1/2, dat is 1/4, en de reden is even nadenken waard, omdat dit de zet is die de intuïtie van de meeste beginners breekt.
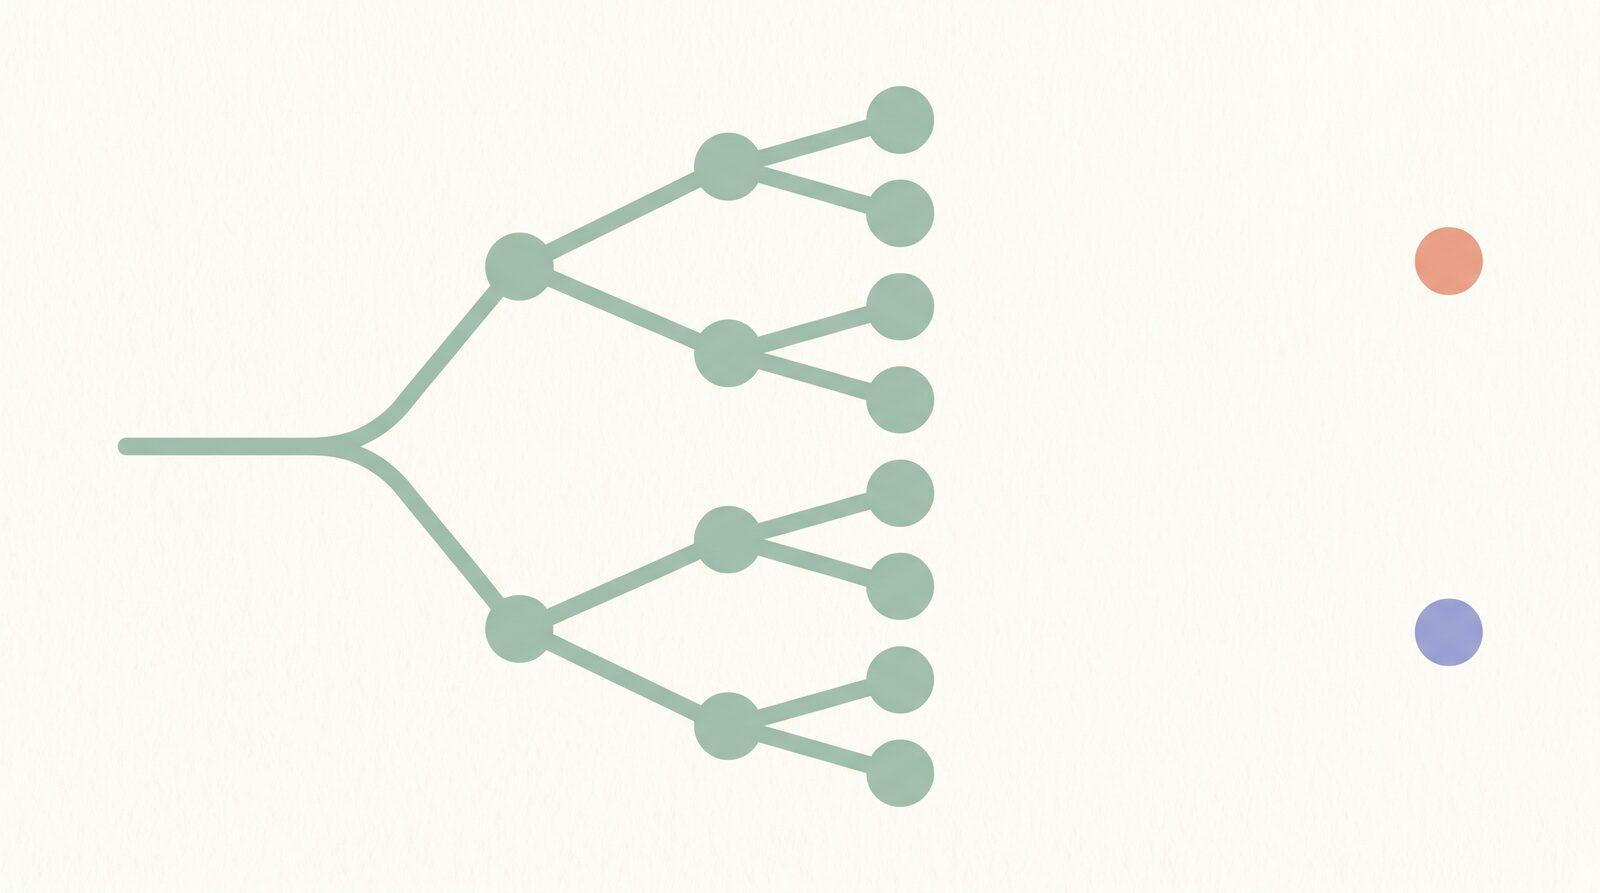
Wanneer twee gebeurtenissen onafhankelijk zijn (de uitkomst van de ene heeft geen effect op de uitkomst van de andere), is de kans dat beide gebeuren het product van hun afzonderlijke kansen. Waarom vermenigvuldigen? Som elke mogelijke uitkomst van twee muntworpen op: KK, KM, MK, MM. Er zijn er vier in totaal, en slechts één daarvan is KK, dus het antwoord is 1/4. De vermenigvuldiging is alleen een snelkoppeling voor die opsomming.
Hetzelfde idee verklaart waarom lange reeksen zo zeldzaam zijn. De kans om tien keer achter elkaar kop te gooien is (1/2) tot de tiende macht, ongeveer 1 op 1.024. Niet onmogelijk, maar niet gewoon. En de kans om een willekeurige zescijferige pincode goed te raden is (1/10) tot de zesde macht, dat is één op de miljoen. Dat is het soort "één op de miljoen" dat écht is. We gaan er zo een paar tegenkomen die dat niet zijn.
Wanneer gebeurtenissen niet onafhankelijk zijn
Onafhankelijkheid is de aanname die meer kansvraagstukken breekt dan welke andere ook. Als je twee kaarten uit een deck trekt zonder de eerste terug te leggen, is de kans op de tweede kaart niet dezelfde als op de eerste, omdat het deck is veranderd. Er zijn 52 kaarten en 4 azen, dus de kans om eerst een aas te trekken is 4/52. Nadat je een aas hebt getrokken, heeft het deck 51 kaarten en 3 azen, dus de kans op een tweede aas is 3/51. De kans op twee azen achter elkaar is daarom 4/52 keer 3/51, ongeveer 0,45 procent.
Dit is voorwaardelijke kans: de kans op één gebeurtenis gegeven dat een andere al heeft plaatsgevonden. Het wordt geschreven als , en het is wat de meeste redenering in de echte wereld écht wil. "Wat is de kans dat het morgen regent?" is één getal. "Wat is de kans dat het morgen regent gegeven dat de radar een onweerscel boven de stad toont?" is een ander, veel hoger getal. De nieuwe informatie herschikt de telling van relevante uitkomsten.
De meeste "paradoxen" in de kansrekening zijn voorwaardelijke-kansproblemen met de conditionering stilletjes verstopt. Ontwar de conditionering, en de paradox verdwijnt meestal.
De verjaardagsparadox
Hier is een vraag die bijna iedereen vangt. In een kamer met 23 mensen, wat is de kans dat minstens twee van hen dezelfde verjaardag hebben?
Het intuïtieve antwoord is klein, omdat er 365 dagen zijn en maar 23 mensen. Het werkelijke antwoord is nét boven de 50 procent. Met 50 mensen in de kamer klimt het naar 97 procent. Met 70 mensen is het boven de 99,9 procent. Dit is de verjaardagsparadox, en het is geen storing in het universum. Het is een storing in de manier waarop intuïtie telt.
De val is dat je niet vraagt "wat is de kans dat iemand op mijn verjaardag jarig is." Je vraagt "wat is de kans dat twee willekeurige mensen dezelfde dag delen." Met 23 mensen zijn er 23 boven 2, dat is 253 verschillende paren mensen, en elk paar heeft een kleine kans om te matchen. Dat zijn veel kansen, en kleine kansen tellen sneller op dan de onderbuik verwacht.
De les is algemeen. Wanneer het aantal kansen op een gebeurtenis kwadratisch groeit (elk paar, elke interactie), worden zeldzame gebeurtenissen snel gewoon. Een kans van 1 op 365 per paar wordt een kans van meer dan de helft overall zodra er 253 paren zijn.
Basispercentages en de truc van één op de miljoen
Een medische test is "99 procent nauwkeurig" voor een ziekte die 1 op de 10.000 mensen treft. Je test positief. Wat is de kans dat je de ziekte écht hebt?
Veel mensen, inclusief artsen, gokken ergens rond de 99 procent. Het juiste antwoord ligt dichter bij 1 procent.
Hier is waarom. Stel je 10.000 willekeurige mensen voor. Ongeveer 1 van hen heeft de ziekte, en de test zal die waarschijnlijk vangen. De andere 9.999 hebben hem niet, maar een test die 99 procent nauwkeurig is, classificeert 1 procent van de gezonde mensen foutief als positief, dat is ongeveer 100 vals-positieven. Dus van elke 101 positieve resultaten zijn er 100 valse alarmen en slechts 1 écht. De kans dat je de ziekte écht hebt, gegeven een positieve test, is grofweg 1 op 101, of ongeveer 1 procent.
Dit is de basispercentage-drogreden. Wanneer de onderliggende gebeurtenis zeldzaam is (laag basispercentage), produceert zelfs een zeer nauwkeurige test vooral vals-positieven. De meeste mensen slaan het basispercentage helemaal over en denken alleen aan de tesnauwkeurigheid, wat hen naar een getal leidt dat twee ordes van grootte fout is.
De les generaliseert ver voorbij de geneeskunde. "1 op de miljoen" is een getal dat altijd een vervolgvraag moet triggeren: 1 op de miljoen van wat? 1 op de miljoen per dag, per jaar, per poging, per persoon? Een dagelijkse gebeurtenis van 1 op de miljoen gebeurt grofweg 365 keer per jaar als de wereld genoeg dagen heeft, en ongeveer 8 miljard keer per jaar als de wereld genoeg mensen heeft. Zodra je de bevolking en het tijdvenster meeneemt, voelt "1 op de miljoen" meestal niet meer zeldzaam. De kop die dit artikel opent werkt hetzelfde: de meeste "wonderen" in het nieuws zijn gebeurtenissen van 1 op de miljoen die enkele miljarden kansen hadden om te gebeuren.
De gokkersdrogreden
Een roulettewiel is acht keer achter elkaar rood geweest. Zwart is toch wel over tijd?
Dat is het niet. Het wiel heeft geen geheugen. De kans op zwart bij de volgende draai is dezelfde als bij de eerste. Dit is de gokkersdrogreden, het geloof dat eerdere onafhankelijke gebeurtenissen de kansen van toekomstige veranderen. Dat doen ze niet.
De spiegelversie van dezelfde fout is de hot-hand-drogreden: het geloof dat een speler die net meerdere keren achter elkaar heeft gescoord, meer kans heeft om de volgende te maken. Voor muntworpen en roulette is dit duidelijk fout, omdat het apparaat geen geheugen heeft. Voor menselijke prestatie is het beeld écht ingewikkelder (echte vaardigheid bestaat, echt momentum bestaat soms), maar de onderliggende les blijft: de meeste reeksen zijn patroonherkenning door een dier dat evolueerde om patronen te vinden of ze er nu waren of niet.
Waar kansrekening opduikt
Zodra je het telkader hebt, verschijnt kansrekening overal.
Weersverwachtingen: 30 procent kans op regen betekent dat het, over een grote set vergelijkbare atmosferische omstandigheden, in ongeveer 30 procent daarvan regende. Het is geen garantie, en het is geen muntworp.
Geneeskunde: elke test, screening en risicoscore omvat de basispercentage-truc hierboven. Een "positieve" test betekent zeer verschillende dingen voor veelvoorkomende en zeldzame aandoeningen, en "99 procent nauwkeurig" zonder basispercentage is bijna betekenisloos.
Verzekering en financiën: elke premie, verwachte opbrengst en risicomodel is een gewogen gemiddelde over mogelijke uitkomsten. De wiskunde is gewoon kans vermenigvuldigd met uitbetaling, opgeteld over alle mogelijke scenario's.
Gestandaardiseerde toetsen: SAT, ACT, GRE, AP Statistics en GCSE bevatten allemaal kansvragen, en veel daarvan zijn voorwaardelijke-kansproblemen in vermomming. Zoals we in onze SAT-voorbereidingsgids opmerkten, is de truc niet het rekenen, het is het herkennen van de structuur.
Machine learning: elke classifier produceert kansen, en elke metriek (precision, recall, ROC-curven) is een zorgvuldige toepassing van voorwaardelijke kans en basispercentages. De basispercentage-drogreden slaat hier opnieuw toe: een model dat 99 procent nauwkeurig is op een zeldzame gebeurtenis kan in productie nog steeds nutteloos zijn.
Kansen snel schatten
De meeste kansvragen in het echte leven hebben geen exact antwoord nodig. Ze hebben een snelle, verdedigbare schatting nodig. Hier zijn de zetten die je het grootste deel van de weg brengen.
Vertaal eerst naar een breuk, dan naar een procent of decimaal. "1 op 100" is 1/100 is 1 procent is 0,01. Zoals we in kopfrekentrucs lieten zien, is vloeiendheid in deze omzettingen een van de vaardigheden met de hoogste hefboom, omdat bijna elk kansprobleem eindigt met een vertaling tussen notaties.
Zoek altijd naar het basispercentage, vooral wanneer iemand je een nauwkeurigheidscijfer geeft voor een zeldzame gebeurtenis. Als het basispercentage klein is, is het nauwkeurigheidscijfer misleidend.
Controleer onafhankelijkheid zorgvuldig. Twee gebeurtenissen lijken onafhankelijk terwijl de ene de andere in feite aandrijft (testresultaten binnen dezelfde patiënt, aandelen binnen dezelfde sector, leerlingen in dezelfde klas). Wanneer gebeurtenissen een verborgen oorzaak delen, geeft het vermenigvuldigen van de kansen een antwoord dat te klein of te groot is.
Stresstest "1 op de miljoen". Vraag: per wat, over hoeveel mensen, over hoe lang? De meeste "zeldzame" gebeurtenissen zijn niet zeldzaam zodra je de kansen telt.
Hoe oefening de reflex bouwt
Kansrekening is het onderwerp waarbij patroonherkenning het meest telt, omdat hetzelfde probleem in twintig verschillende kostuums binnenkomt. De leerling die de structuren gezien en opnieuw gezien heeft (onafhankelijk versus afhankelijk, met teruglegging versus zonder, voorwaardelijk versus gezamenlijk) begint de structuur binnen seconden te spotten, en het rekenen valt uit die herkenning.
De bucketprogressie van Math Zen sluit schoon aan op hoe het onderwerp écht geleerd wil worden. De vroegste buckets dekken het tellen van uitkomsten voor eenvoudige experimenten (dobbelstenen, kaarten, munten). De middelste buckets oefenen de vermenigvuldigingsregel en de optelregel voor unies, met gemengde oefening zodat het brein leert de situatie te herkennen in plaats van blind een formule toe te passen. De latere buckets werken aan voorwaardelijke kans, verwachte waarde, en de klassieke puzzels (verjaardagsparadox, Monty Hall, basispercentageproblemen). Omdat de oefening kort en gespreid is, krijg je herhaalde kansen om de structuur te herkennen, en dat is wat de regels uiteindelijk in reflexen verandert.
De conclusie
Kansrekening is één idee: tel de uitkomsten die matchen, deel door alle uitkomsten die bestaan, en wees eerlijk over of de gebeurtenissen die je telt écht onafhankelijk zijn. De "paradoxen" zijn alleen situaties waarin de onderbuik iets anders telt dan de wiskunde. Vermenigvuldig wanneer gebeurtenissen onafhankelijk zijn. Tel op wanneer je de kans op de een of de ander wilt (trek de overlap af, zodat je niet dubbeltelt). Conditioneer wanneer nieuwe informatie binnenkomt. Zoek altijd naar het basispercentage, vooral wanneer iemand je een "1 op de miljoen" aanreikt.
Zodra je begint te vragen "1 op de miljoen van wat, per wat, over hoeveel?" stopt de alledaagse wereld ermee om op dezelfde manier willekeurig te voelen. De loterij wordt een klein verwacht verlies met zeldzame jackpots. De medische test wordt een vraag over basispercentages. De hot streak wordt een toeval dat het brein aankleedt met causaliteit. De getallen veranderen niet, maar de manier waarop je ze leest wel, en die verandering loont voor altijd.