變異數與標準差的差別:例題詳解指南
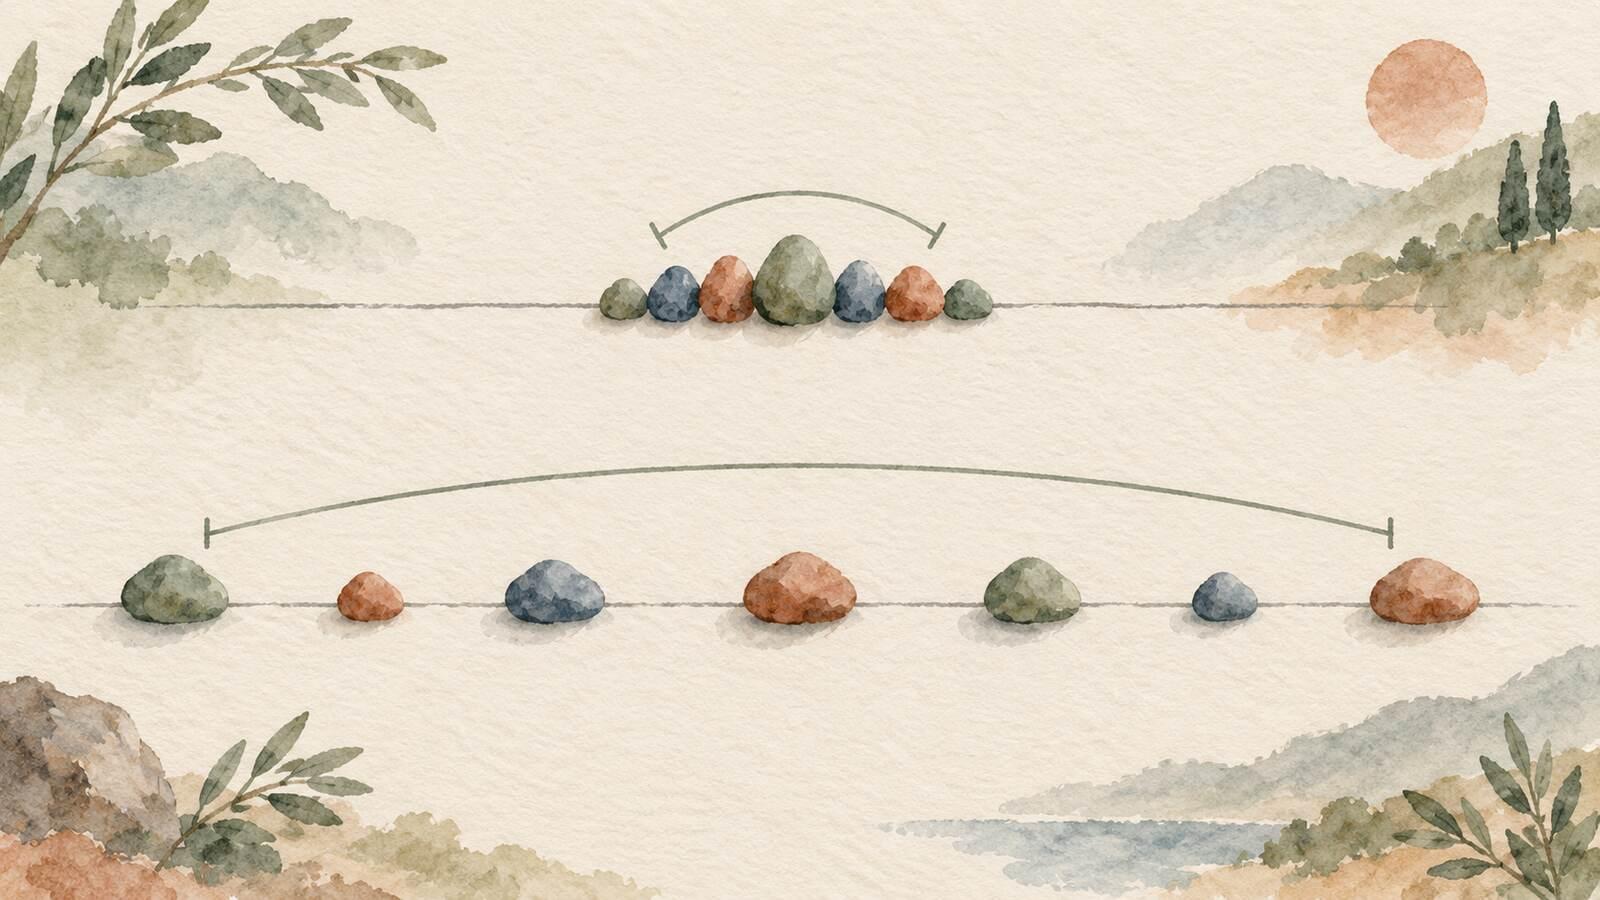
兩組人完成同一個拼圖,平均都花四分鐘。第一組每個人都是四分鐘完成。第二組有一半人花兩分鐘,另一半花六分鐘。兩組的平均數相同,但第二組的時間分散得多。變異數與標準差就是替這個差別標上數字。
它們衡量的是同一個底層特徵:圍繞平均數的分散程度,只是用不同的尺度來表示。變異數使用平方後的單位。標準差取它的平方根,回到原本的單位。如果資料的單位是分鐘,變異數的單位就是平方分鐘,標準差的單位則是分鐘。計算方式也會依據你的資料是涵蓋整個母體,還是只是一個樣本而有所不同。
這份指南會用一組資料從頭算到尾。如果你想先了解平均數、中位數與分布的整體概念,請先閱讀我們的統計入門。
從離均差開始
假設八次拼圖嘗試所花的分鐘數如下:
它們的總和是 分鐘,所以平均數是 分鐘。下一步是把每個時間都減去五。離均差為:
負數代表比平均更快;正數代表比平均更慢。這些離均差加起來是零,算術平均數的離均差永遠如此。所以直接取它們的平均,即使資料的數值差異很大,也會報告出零的分散程度。這毫無用處。把每個離均差平方,既能使它變成非負的,也讓較大的偏離有更大的影響力,NIST 關於尺度量數的參考資料就是這樣說明的。
以下是八個離差平方:
| 時間(分鐘) | 與 5 的離均差(分鐘) | 離差平方(分鐘²) |
|---|---|---|
| 2 | -3 | 9 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 5 | 0 | 0 |
| 5 | 0 | 0 |
| 7 | 2 | 4 |
| 9 | 4 | 16 |
最後一欄的總和是 平方分鐘。這個和是兩個統計量的引擎。從這裡開始,所觀察到的時間都不會再改變。分母則取決於這八個時間代表什麼。
如果這是整個母體
想像這八次嘗試,就是你所關心的那個小型比賽中的每一次嘗試。你是在描述這個完整的群體,而不是在估計一個更大、看不見的群體。把離差平方和除以資料個數 :
這就是母體變異數,符號是 。接著取平方根:
這就是母體標準差。這個平方根並不是把計算還原,變成平均絕對距離。它是在離差已經被平方並合併之後,把單位與尺度還原。OpenStax 關於資料分散程度的章節給出了相同的母體符號與分母。
這裡的兩分鐘是什麼意思?它是以分鐘表示的、這些時間圍繞五分鐘平均數的分散程度。它並不表示每一個結果都落在五分鐘的兩分鐘範圍內:這份資料裡就有二和九。它也不表示必然有某個特定比例的資料落在那個範圍內。這類百分比規則需要對分布做出假設,而不是光憑算出來的標準差。
如果這是一個樣本
現在想像這同樣的八個時間,是從一個大得多的嘗試集合中選出來的,而你想估計那個更大的母體有多分散。觀察到的平均數 5,本身就是用這個樣本算出來的。通常的樣本變異數在分母使用 :
樣本標準差則是:
結果比母體的計算稍微大一些,因為同樣的和 是除以七而不是八。這不是在寬鬆與嚴格的公式之間做選擇。它回答的是兩個不同的問題:把這八個值當成完整群體來描述,或是用八個觀察值去估計更大群體的分散程度。OpenStax 的資料科學教材列出了兩種公式與單位上的差別。
為什麼是七?樣本平均數是用這些同樣的觀察值配出來的,這往往會讓它們的離差看起來比相對於未知母體平均數的離差更小。在一般的抽樣設定下,使用 可以修正變異數的這種偏低傾向。一個好用的記憶法是:固定樣本平均數之後,有七個離差可以自由變動;第八個必須讓它們的總和為零。更深層的統計理由,涉及樣本變異數在重複抽樣中的表現。對這篇文章來說,實用的規則就夠了:在除之前,先確定你手上的是母體還是樣本。
你應該報告哪一個數?
當計算需要平方後的分散程度,或是你正在使用以變異數定義的公式做進一步的統計工作時,使用變異數。當你想讓讀者把分散程度與原本的測量值比較時,使用標準差。「標準差約 2.14 分鐘」可以立刻與五分鐘的平均數比較;「變異數約 4.57 平方分鐘」在數學上是精確的,但比較難想像。
務必附上所採用的慣例。「SD = 2」與「SD = 2.14」都來自同樣的八個時間;如果沒有標明母體或樣本,讀者就無法知道它們為什麼不同。如果你的計算機提供 與 ,這兩個按鍵不能互換。完整母體的描述用 ,樣本的計算用 。
單位也很重要。如果數值的單位是公分,變異數的單位是 ,標準差的單位是公分。如果數值是沒有單位的得分,兩個結果也都沒有單位。把兩個數都稱為「分」,或都稱為「平方分」,就掩蓋了平方根做了什麼。
為什麼不直接用全距?
我們這組時間的全距是 分鐘。這只告訴你兩個極端值之間的距離,對夾在中間的六個值毫無說明。只要固定二和九,改變中間的某個值,全距仍然是七,即使整體的樣貌已經改變。變異數與標準差使用每一個觀察值,所以中間值的改變會影響結果。
這個優點也帶來限制:平方會讓遠離的值具有相當大的影響力。在這份例題資料中,光是九分鐘的那次嘗試,就貢獻了 平方分鐘總和中的 。當大幅度的偏離很重要時,這是個優點,但這也表示在解讀單一的分散數字之前,你應該先看看資料。NIST 在比較各種分散量數時也指出,大的離差有較強的影響。標準差無法取代你對異常值或不對稱分布的察覺。
為了建立直覺,比較兩組各四個值、平均數都是四的資料: 與 。第一組的離差平方為零,標準差也為零。第二組中,每個值都離四有兩個單位,所以每個離差平方是四。把每一組都視為完整的母體,它的變異數是四,標準差是二。光看共同的平均數,就完全錯過了這個區別。
常見的計算錯誤
在決定資料代表什麼之前就先除。 在計算上方寫下「母體」或「樣本」。母體用 ;用來估計母體的樣本變異數,則用 。把兩者混用,是兩個看似正確的答案互不相同的最常見原因。
忘了開平方根。 總和除以分母得到的是變異數。標準差是那個數的平方根。如果題目要求兩者,就兩個都報告。
漏掉單位。 離差平方和與變異數的單位是平方單位;標準差的單位是原單位。這是檢查自己作答的快速方法。
把它稱為平均絕對差。 那是另一種量數,稱為平均絕對離差。標準差是先平方,再依母體或樣本的慣例取平均,最後開平方根。這些運算通常會得到不同的值。
每一列都四捨五入。 盡可能保留精確的離差平方與精確的分數。對這份資料來說, 比對四捨五入後的變異數開根號,能給出更準確的樣本標準差。
不抄表格自己練習
試試 ,並把這四個值當作完整的母體。平均數是 。離均差是 ,所以離差平方和是 。母體變異數是 平方單位,母體標準差是 單位。如果這四個值構成的是一個樣本,就除以三:樣本變異數 ,樣本標準差 。
只把最後一個值從五改成九。在計算之前,先預測分散程度會不會上升。它會上升,但請重新做一遍算術:平均數也改變了,所以你不能只更新舊的離均差表中的一列。這是很好的練習,讓你看出為什麼平均數與分散程度必須一起計算。
等你能親手完成一張表格之後,Math Zen 的統計練習就很有用了。用它來練習辨識平均數、選擇正確的分母,以及檢查你答案的單位是否合理。如果樣本與母體的區別仍然感覺抽象,我們的機率指南解釋了為什麼要用樣本來推論更廣泛的一組結果。
常見問題
變異數一定比標準差大嗎?
不一定。它們的單位不同,所以直接比大小通常沒有意義。就數值而言,如果某個選定單位下的變異數小於一,它的平方根會比變異數大;如果大於一,它的平方根會比變異數小。改變單位可以改變這種數值上的比較,卻不會改變資料。
標準差可以是負的嗎?
不可以。離差平方是非負的,它們的總和是非負的,而用於標準差的平方根也是非負的。只有當所有觀察值都相等時,它才是零。
什麼時候用 n 減 1?
當樣本平均數是用那些資料算出來時,一般的樣本變異數與樣本標準差使用 。當資料是你打算描述的整個母體時,使用 。在碰計算機之前,先檢查題目的措辭。
要記住這個區別,最簡單的方法是什麼?
變異數是透過平方離差來衡量的分散程度。標準差是那個變異數的平方根,回到資料原本的單位。上面的例子從總共 平方分鐘,到母體變異數 平方分鐘,再到母體標準差 分鐘。
常見問題
- 變異數與標準差有什麼差別?
- 母體的變異數是各資料與平均數離差平方的平均值;樣本的變異數則是離差平方和除以 n 減 1。標準差是對應變異數的平方根,所以使用的是資料原本的單位。
- 為什麼樣本變異數要除以 n 減 1?
- 樣本平均數是用同一批資料估計出來的。拿這批樣本去估計母體變異數時,離差平方和除以 n 減 1,可以修正通常會偏低的偏誤。若資料是完整的母體,則除以 N。
- 標準差是各資料到平均數的平均距離嗎?
- 不是。標準差是先把離差平方,再依適當的分母取平均,最後開平方根得到的。平均絕對離差則是把絕對距離取平均。兩者都在衡量分散程度,但是不同的數。