統計學怎麼理解?「平均」藏起了什麼
統計學是從資料中理出意義的數學,是從一堆變動的數字裡抽出可靠訊號的方法。它有兩項工作:概括你手上已有的資料(一個班的考試成績、一個月的銷售額),以及讓你推論那些你無法完整看到的事(從一千人的民調推知全國人民的意見)。本文從零開始建立這兩個想法,接著說明大家熟悉的名詞(平均數、中位數、標準差、鐘形曲線)究竟從何而來。
統計學有個形象問題。許多學生接觸它時,只是一包要背的公式:這個是變異數,那個是標準誤,第三個是相關係數。公式套用了,答案算出來了,意義卻始終沒有到來。
讓我們來修正這件事。
是兩項工作,不是一項
入門統計課程裡的一切,都可以分進兩個類別。
敘述統計概括你已有的資料。如果你量了一所學校每位學生的身高,敘述統計會把這幾百個數字濃縮成幾個抓住本質的數:典型的身高、身高的變動程度,以及分布的形狀。
推論統計則是針對你沒有的資料做推理。你不可能量遍地球上每個成年人的身高,所以你量一個樣本,再對所有人做推論。民調、醫學試驗和品質管制都屬於這一類。它是比較強大的那一半,而它完全建立在敘述統計之上。
統計學中幾乎所有的困惑,只要問一句就會清楚:我是在描述手上有的資料,還是在推論我沒有的資料?先從描述開始。
中心:資料落在哪裡
對任何資料集的第一個問題是「典型的值是多少?」有三個誠實的答案,而且它們刻意不一致。
平均數是大多數人所說的平均:全部加起來,除以個數。它用到每一個數值,這既是它的優點,也是它的弱點。
中位數是把資料排序後位於中間的數值。一半的數值在它之上,一半在它之下。它不在意極端值有多極端,只在意位置。
眾數是出現次數最多的數值。它是唯一適用於無法取平均的東西的指標,例如賣得最多的鞋子尺寸。
對於對稱的資料,三者大致落在同一個地方,這些區別感覺只是學術上的。但只要資料是偏斜的,這些區別就不再只是學術。
想像一個房間裡有九位學校老師和一位億萬富翁。所得的中位數描述的是一位普通老師,因為位在中間的那個人是老師。所得的平均數則高達數千萬,因為億萬富翁把它拉高了。兩個數字都是對的,但只有一個對房間裡的一般人是誠實的。
這是閱讀統計時最重要的一個習慣:當有人報告一個「平均」時,要問那是平均數還是中位數,也要問資料是否偏斜。所得、房價、等待時間與觀看次數幾乎都是偏斜的,而平均數幾乎總是在美化它們。
離散程度:為什麼只有中心還不夠
兩組資料可以有完全相同的平均數,卻毫不相像。
A 班成績:70、72、70、68、70。平均:70。 B 班成績:40、95、100、50、65。平均:70。
平均相同,故事卻完全不同。A 班很穩定,B 班一片混亂。光靠平均數無法區分它們,所以我們需要一個衡量離散程度的數。
粗略的版本是全距,也就是最大值減最小值。它很簡單,卻很脆弱,因為只依賴兩個數,一個離群值就能破壞它。
正式的版本是標準差,而它背後的想法比公式看起來簡單。問:平均來說,每個數值離平均數多遠?量出每個數值與平均數的距離,再對這些距離取某種平均。標準差小,表示一切都擠在中心附近(A 班)。標準差大,表示數值被甩到四面八方(B 班)。
公式之所以要把距離平方,最後再開根號(而不是直接把原始距離取平均),主要是為了讓正的差距與負的差距不會互相抵銷,也讓較大的偏離佔更大的份量。但它的意義始終不變:標準差是離平均的典型距離,單位和資料相同。如果考試成績的標準差是 8 分,那麼「上下差個 8 分」就是你對成績分散程度的感覺。
平均數告訴你位置在哪裡。標準差則告訴你,「位置在哪裡」這個說法能多可靠地描述任何一個個案。
形狀:鐘形曲線,以及它為什麼無所不在
有了中心與離散程度之後,下一個自然的問題是資料的整體形狀。畫出每個數值出現的頻率,你就得到一個分布。
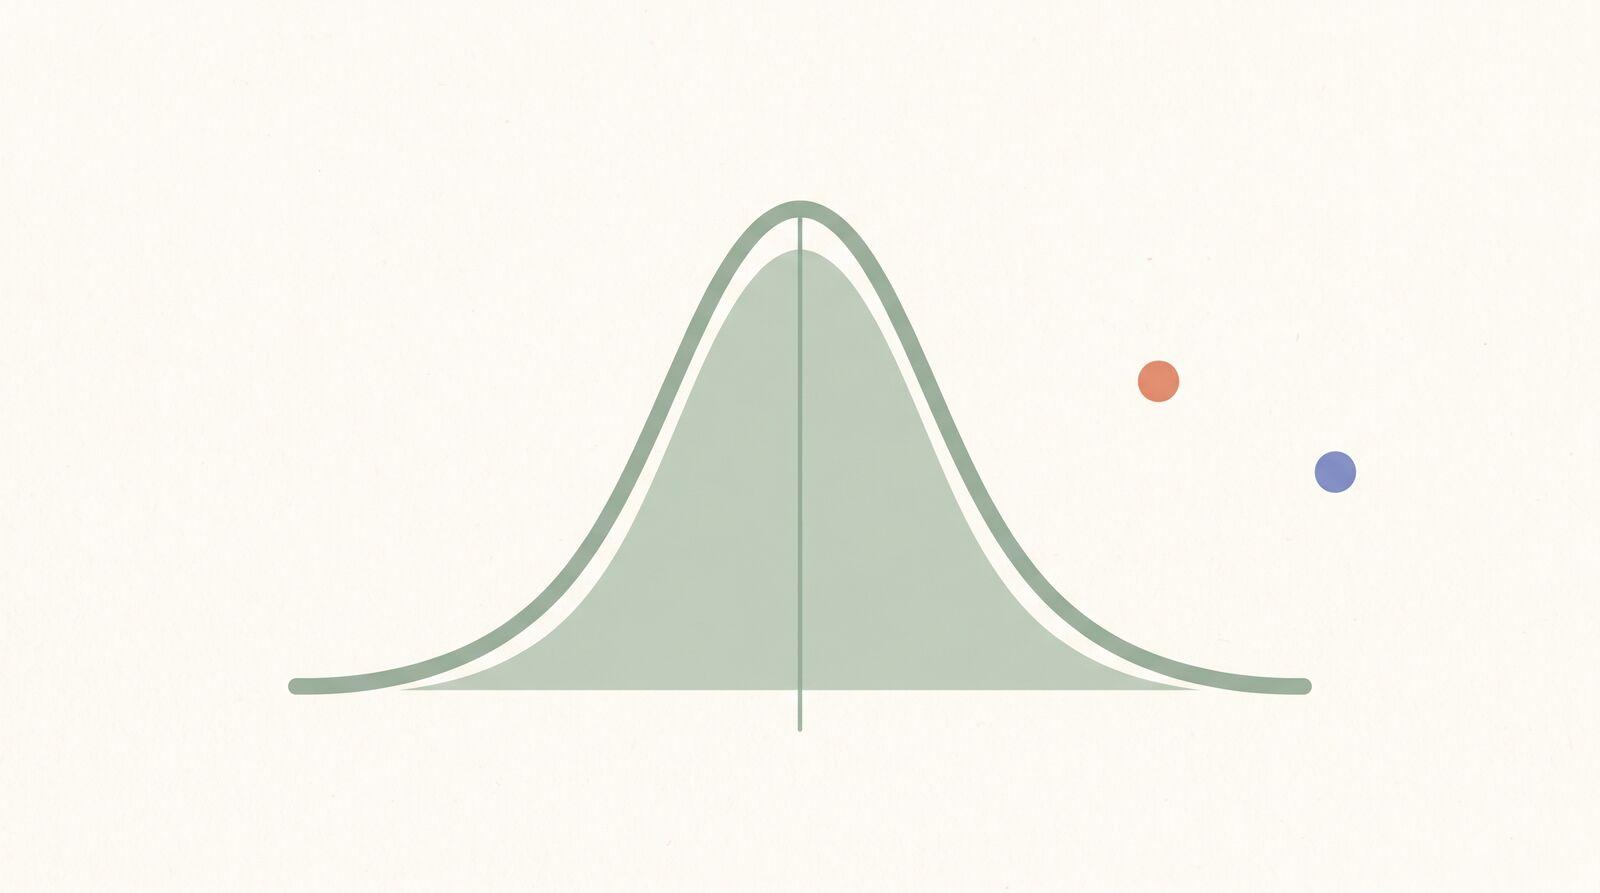
最有名的形狀是常態分布,也就是鐘形曲線:左右對稱,大部分數值聚集在平均附近,越往兩端越少。身高、測量誤差和許多自然界的量都非常接近它。
鐘形曲線之所以這麼常出現,有一個深層的原因。當一個量是許多微小而獨立的影響的總和時(你的身高是基因、營養、睡眠,加上其他上百種推動力的總和),結果往往會趨向鐘形曲線,幾乎不管每一個影響各自的表現如何。這就是統計學中最重要的結果之一,中央極限定理的大致想法,也是為什麼常態分布成為如此多推論的預設背景。
鐘形曲線也讓標準差有了具體的回報。對於常態資料,約 68% 的數值落在平均數加減一個標準差之內,約 95% 落在兩個標準差之內,約 99.7% 落在三個標準差之內。所以如果成年人的身高平均為 170 公分、標準差為 7 公分,那麼大約 95% 的人落在 156 到 184 公分之間。離散程度這個數就不再抽象,而開始預測東西實際落在哪裡。
相關不等於因果
當兩個量一起變動時,我們說它們相關。較高的人往往較重:身高與體重呈正相關。一個上升,另一個也上升。
陷阱在於把相關當成因果的證明。冰淇淋銷量與溺水死亡人數每年夏天都一起上升。冰淇淋不會造成溺水。是第三個隱藏因素,炎熱的天氣,同時推動了兩者。這是干擾變數,也是光靠相關永遠無法證明因果的原因。
相關是真實的線索,它告訴你該往哪裡找。但要主張 A 造成 B,還需要更多:受控實驗、合理的機制,以及排除干擾變數。宣稱「做 X 的人活得比較久」的新聞標題,幾乎都建立在相關之上,而且幾乎都言過其實。以懷疑的眼光閱讀這類報導,是統計學教給你最有用的事情之一。
推論:少數人如何代表多數人
現在來看強大的那一半。一份一千人的全國民調,宣稱代表三億人。這怎麼不荒謬?
關鍵的洞察是,隨機性在大量資料下是可以預測的。如果你的樣本真的是隨機且具代表性,機率的數學就能告訴你,你的估計可能偏離多少。這種不確定性以誤差範圍報告:「52%,正負 3 個百分點」,意思是真實的數字非常可能落在 49% 到 55% 之間。
有兩件事決定你能不能信任一個推論:
- 樣本數控制隨機雜訊。樣本越大,誤差範圍越窄,不過報酬遞減:要把誤差減半,大約需要四倍的樣本。
- 樣本品質控制偏誤,而偏誤是更致命的問題。對一百萬名都造訪同一個網站的人做的民調,告訴你的是那個網站的情況,不是全國的情況。沒有任何樣本數能修正一個有系統地排除了某些人的樣本。代表性第一;樣本數只會讓一個本來就公平的樣本更精準。
這就是為什麼面對任何統計數字,該問的不只是「研究的規模多大」,而是「實際上有誰在裡面,又有誰被排除在外」。
要留意的常見陷阱
統計學本身是誠實的,但它被報導的方式往往不是。以下是幾種要抓出來的模式:
- 被平均掉的平均。「平均顧客滿意度很高」,可能掩蓋了一群非常滿意與非常憤怒的顧客分成兩派、中間幾乎沒有人的情況。永遠要問離散程度,而不只是中心。
- 被截斷的坐標軸。 垂直軸從 90 而不是 0 開始的長條圖,會把微小的差異變成戲劇性的斷崖。數字是真的,圖卻在說謊。
- 遺失的分母。「病例數翻倍」,如果不知道是從二增加到四,還是從兩百萬增加到四百萬,就毫無意義。百分率的變化有多大意義,取決於它是以什麼基準來衡量。
- 挑選過的起訖點。 只要選對起始和結束日期,幾乎任何趨勢都能被做成往上或往下。
這與數學其他部分的關係
統計學並不是獨立存在的。它建立在你可能已經接觸過的想法之上。它由機率構成,機率提供了隨機樣本如何表現、誤差範圍從何而來的規則。它報告的幾乎每個結果都倚賴百分率與比例。而它所仰賴的平滑曲線,也就是把分布變成機率的鐘形曲線下面積計算,與微積分中的積分是同一套想法,只是用在資料上。
當你在 Math Zen 練習統計時,題目會從敘述性的指標(計算並比較平均數、中位數與標準差)進展到解讀分布與推論樣本。用手算而不是讓計算機吐出一個數字,能培養你問出正確問題的直覺:這個中心誠實嗎、這個離散程度小到足以信任嗎、這個相關真的告訴了我什麼嗎?隨著時間混合練習這些題型,並運用練習流程中內建的間隔重複,才能讓直覺牢牢留下,而不是考完試就消退。
重點整理
統計學是兩項工作:描述你擁有的資料,以及推論你沒有的資料。描述需要三個東西:中心(平均數或中位數,資料偏斜時該選哪一個很重要)、離散程度(標準差,離中心的典型距離),以及形狀(通常是鐘形曲線)。推論則需要一個代表性第一、樣本數第二的樣本,以及誠實的誤差範圍。
下次看到一個統計數字時,不要只讀那個數字。問:是平均數還是中位數?離散程度多大?樣本裡有誰?是相關還是因果?這四個問題,會把統計學從一面公式牆,變成一項不被愚弄的工具。
常見問題
- 平均數、中位數與眾數有什麼差別?
- 平均數是算術平均,也就是所有數值的總和除以個數。中位數是把資料排序後位於中間的數值,一半在它之上,一半在它之下。眾數是出現次數最多的數值。資料對稱時三者會一致,但資料偏斜時就會分開,而這正是選擇哪一個才重要的時候。
- 什麼時候該用中位數而不是平均數?
- 只要少數極端值會把平均數拉到不具代表性的地方,就該用中位數。所得、房價與回應時間都是典型的例子。一屋子老師裡只要有一位億萬富翁,平均所得就會產生誤導,但中位數仍然描述了屋裡一般人的情況。
- 標準差到底衡量什麼?
- 標準差衡量資料圍繞平均數散開的程度,單位與資料本身相同。標準差小,表示數值緊緊聚在平均附近。標準差大,表示數值分散得很廣。它回答了平均數回答不了的問題:所謂的「典型」到底有多典型。
- 相關與因果有什麼差別?
- 相關是指兩件事傾向一起變動。因果是指其中一件事真的造成另一件事發生。冰淇淋銷量與溺水人數會一起上升,但兩者互不造成對方,是夏天的高溫同時推動了兩者。相關是值得追查的線索,但本身絕不是證據。
- 為什麼樣本數越大越好?
- 樣本越大,隨機雜訊越小,所以結果越有可能反映真實的母體。但有個關鍵:樣本數無法修正有偏誤的樣本。對一百萬名都讀同一個網站的人做的民調,結果仍然是偏的。代表性比樣本數重要,有了代表性之後,樣本數才會讓估計更精準。