Förstå statistik intuitivt (vad "medelvärde" döljer)
Statistik är matten i att få vett av data, att dra en pålitlig signal ur en hög tal som varierar. Den gör två jobb: den sammanfattar det du redan har (en klass provresultat, en månad försäljning) och den låter dig resonera om det du inte kan se i sin helhet (åsikterna i ett helt land från en undersökning av tusen personer). Den här artikeln bygger båda idéerna från grunden, och visar sedan var de bekanta termerna (medelvärde, median, standardavvikelse, klockkurvan) faktiskt kommer ifrån.
Statistik har ett ryktesproblem. Många elever möter den som en påse formler att memorera: den här för varians, den där för standardfel, en tredje för korrelationskoefficienten. Formlerna tillämpas, svaren räknas ut, och betydelsen kommer aldrig.
Låt oss laga det.
Två jobb, inte ett
Allt i en inledande statistikkurs faller i en av två hinkar.
Beskrivande statistik sammanfattar data du har. Om du mätte längden på varje elev i en skola kokar beskrivande statistik ner de hundratals talen till några som fångar kärnan: en typisk längd, hur mycket längder varierar, hur formen på fördelningen ser ut.
Inferentiell statistik resonerar om data du inte har. Du kan inte mäta längden på varje vuxen på jorden, så du mäter ett stickprov och sluter dig till något om alla. Här bor opinionsundersökningar, medicinska studier och kvalitetskontroll. Det är den kraftfullare hälften, och den vilar helt på den beskrivande hälften.
Nästan varje förvirring i statistik klarnar när du frågar: beskriver jag det jag har, eller sluter jag mig till det jag inte har? Börja med att beskriva.
Centrum: var datan sitter
Den första frågan om varje dataset är "vad är ett typiskt värde?" Det finns tre ärliga svar, och de är oense med avsikt.
Medelvärdet är det de flesta kallar genomsnittet: addera allt, dividera med antalet. Det använder varje värde, vilket är dess styrka och dess svaghet.
Medianen är det mittersta värdet när du sorterat datan. Hälften av värdena sitter ovanför, hälften under. Den ignorerar hur extrema extrema är och bryr sig bara om position.
Typvärdet är värdet som dyker upp oftast. Det är det enda som fungerar för saker du inte kan medelvärdesbilda, som den mest sålda skostorleken.
För symmetrisk data landar alla tre ungefär på samma ställe, och distinktionen känns akademisk. Distinktionen slutar vara akademisk i samma ögonblick som datan är skev.
Föreställ dig ett rum med nio skollärare och en miljardär. Medianinkomsten beskriver en vanlig lärare, för den mittersta personen är en lärare. Medelinkomsten ligger i tiotals miljoner, för miljardären drar upp den. Båda talen är korrekta. Bara ett är ärligt om en typisk person i rummet.
Det här är den allra viktigaste vanan när du läser statistik: när någon rapporterar ett "genomsnitt," fråga om det är ett medelvärde eller en median, och fråga om datan är skev. Inkomster, huspriser, väntetider och visningsantal är nästan alltid skeva, och medelvärdet smickrar dem nästan alltid.
Spridningen: varför centrum inte räcker
Två dataset kan dela exakt samma medelvärde och inte likna varandra alls.
Klass A-resultat: 70, 72, 70, 68, 70. Medelvärde: 70. Klass B-resultat: 40, 95, 100, 50, 65. Medelvärde: 70.
Samma genomsnitt, helt olika historier. Klass A är konsekvent. Klass B är kaotisk. Medelvärdet ensamt kan inte skilja dem, så vi behöver ett tal för spridning.
Den grova versionen är variationsvidden, det största värdet minus det minsta. Den är lätt men skör, för den beror på bara två tal och en avvikare slår sönder den.
Den seriösa versionen är standardavvikelsen, och idén bakom den är enklare än formeln antyder. Fråga: i genomsnitt, hur långt är varje värde från medelvärdet? Mät varje värdes avstånd från medelvärdet, och ta sedan ett slags genomsnitt av de avstånden. En liten standardavvikelse betyder att allt klungar nära centrum (klass A). En stor betyder att värden slungas vitt och brett (klass B).
Skälet till att formeln kvadrerar avstånden och sedan tar en kvadratrot i slutet (i stället för att bara medelvärdesbilda de råa avstånden) är mest så att positiva och negativa gap inte tar ut varandra, och så att större avvikelser räknas mer. Men betydelsen ändras aldrig: standardavvikelse är det typiska avståndet från genomsnittet, rapporterat i samma enheter som datan. Om provresultat har en standardavvikelse på 8 poäng är "plus minus 8 poäng" din känsla av hur mycket resultat vandrar.
Medelvärdet talar om var. Standardavvikelsen talar om hur mycket du kan lita på "var" för att beskriva ett enskilt fall.
Formen: klockkurvan och varför den är överallt
När du har centrum och spridning är den naturliga nästa frågan den övergripande formen på datan. Rita hur ofta varje värde förekommer och du får en fördelning.
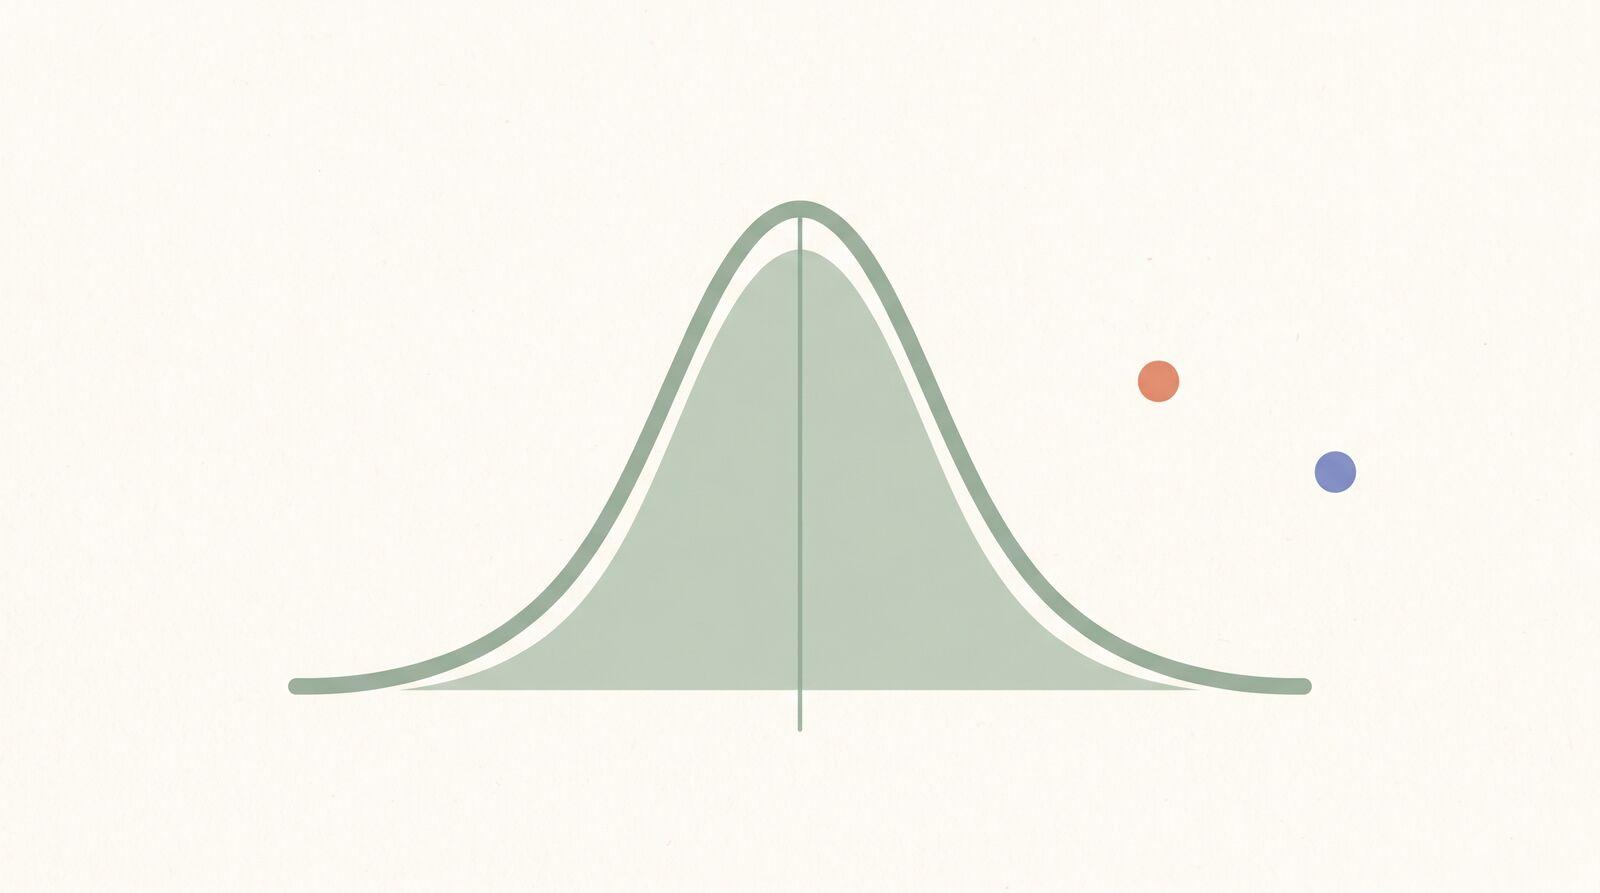
Den mest kända formen är normalfördelningen, klockkurvan: symmetrisk, med de flesta värden buntrade nära medelvärdet och färre och färre när du rör dig ut mot extrema. Längder, mätfel och många naturliga storheter följer den tätt.
Klockkurvan dyker upp så ofta av ett djupt skäl. När en storhet är summan av många små oberoende influenser (din längd är gener plus näring plus sömn plus hundra andra knuffar) tenderar resultatet mot en klockkurva, nästan oavsett hur varje enskild influens beter sig. Det är den grova idén bakom ett av de viktigaste resultaten i all statistik, centrala gränsvärdessatsen, och det är varför normalfördelningen är standardbakgrunden för så mycket inferens.
Klockkurvan ger också standardavvikelsen en konkret utdelning. För normal data faller ungefär 68 procent av värdena inom en standardavvikelse från medelvärdet, ungefär 95 procent inom två, och ungefär 99,7 procent inom tre. Så om vuxenlängder har ett medelvärde på 170 cm och en standardavvikelse på 7 cm faller ungefär 95 procent av människor mellan 156 och 184 cm. Spridningstalet slutar vara abstrakt och börjar förutsäga var saker faktiskt landar.
Korrelation är inte kausalitet
När två storheter rör sig tillsammans säger vi att de är korrelerade. Längre personer tenderar att väga mer: längd och vikt är positivt korrelerade. När den ena går upp gör den andra det också.
Fällan är att behandla korrelation som bevis på orsak. Glassförsäljning och drunkningsdödsfall stiger tillsammans varje sommar. Glass orsakar inte drunkning. En dold tredje faktor, varmt väder, driver båda. Det här är en confounder, och det är skälet till att korrelation ensam aldrig etablerar kausalitet.
Korrelation är en äkta ledtråd. Den talar om var du ska titta. Men för att hävda att A orsakar B behöver du mer: ett kontrollerat experiment, en rimlig mekanism, och eliminering av confounders. Rubrikerna som tillkännager "människor som gör X lever längre" vilar nästan alltid på korrelation, och räcker nästan alltid för långt. Att läsa det skeptiskt är en av de mest användbara sakerna statistik lär.
Inferens: hur få talar för många
Nu den kraftfulla hälften. En nationell opinionsundersökning av 1 000 personer hävdar att representera 300 miljoner. Hur är det inte absurt?
Nyckelinsikten är att slump är förutsägbar i bulk. Om ditt stickprov är genuint slumpmässigt och representativt talar sannolikhetens matte om hur långt ifrån din skattning troligen är. Den osäkerheten rapporteras som en felmarginal: "52 procent, plus minus 3 enheter" betyder att den sanna siffran mycket troligen ligger mellan 49 och 55 procent.
Två saker avgör om du kan lita på en inferens:
- Stickprovsstorlek styr slumpbrus. Större stickprov ger smalare felmarginaler, fast med avtagande avkastning: att halvera felet tar ungefär fyra gånger stickprovet.
- Stickprovskvalitet styr bias, och bias är det dödligare problemet. En undersökning av en miljon personer som alla besöker samma webbplats talar om den webbplatsen, inte landet. Ingen stickprovsstorlek lagar ett stickprov som systematiskt utesluter människor. Representativitet kommer först; storlek skärper bara ett redan rättvist stickprov.
Därför är frågan att ställa om vilken statistik som helst inte bara "hur stort var studien" utan "vem var faktiskt med, och vem lämnades utanför."
Vanliga fällor att se upp för
Statistik är ärlig. Sättet den rapporteras på är ofta inte det. Några mönster att fånga:
- Det bortmedelade genomsnittet. "Genomsnittlig kundnöjdhet är hög" kan dölja en splittrad skara mycket glada och mycket arga kunder, med nästan ingen i mitten. Fråga alltid om spridning, inte bara centrum.
- Den avhuggna axeln. Ett stapeldiagram vars vertikala axel börjar på 90 i stället för 0 förvandlar en liten skillnad till en dramatisk klippa. Talen är äkta; bilden ljuger.
- Den saknade nämnaren. "Fallen fördubblades" är meningslöst utan att veta om det är två till fyra eller två miljoner till fyra miljoner. En procentuell förändring är bara så meningsfull som basen den mäts mot.
- Handplockade ändpunkter. Välj rätt start- och slutdatum och nästan varje trend kan fås att peka upp eller ner.
Hur det här kopplar till resten av matten
Statistik står inte ensam. Den sitter ovanpå idéer du kanske redan mött. Den är byggd av sannolikhet, som levererar reglerna för hur slumpmässiga stickprov beter sig och var felmarginaler kommer ifrån. Den lutar sig mot procent och proportioner för nästan varje resultat den rapporterar. Och de mjuka kurvor den förlitar sig på, area-under-klockkurvan-beräkningarna som förvandlar en fördelning till en sannolikhet, är samma integrationsidéer från analysen, tillämpade på data.
När du övar statistik i Math Zen går problemen från beskrivande mått (att räkna och jämföra medelvärden, medianer och standardavvikelser) in i att läsa fördelningar och resonera om stickprov. Att arbeta dem för hand, i stället för att låta en räknare spotta ut ett tal, är det som bygger instinkten att ställa rätt fråga: är det här centrumet ärligt, är den här spridningen liten nog att lita på, talar den här korrelationen faktiskt om något? Att blanda de problemtyperna över tid, med den utspridda repetitionen inbyggd i övningsflödet, är det som får intuitionen att sitta i stället för att blekna efter provet.
Sammanfattning
Statistik är två jobb: att beskriva datan du har och att sluta sig till datan du inte har. Att beskriva behöver tre tal, ett centrum (medelvärde eller median, och valet spelar roll när data är skev), en spridning (standardavvikelse, det typiska avståndet från centrum), och en form (ofta klockkurvan). Att sluta sig till behöver ett stickprov som är representativt först och stort sedan, och en ärlig felmarginal.
Nästa gång du ser en statistik, läs inte bara talet. Fråga: medelvärde eller median? Hur mycket spridning? Vem var i stickprovet? Korrelation eller orsak? De fyra frågorna förvandlar statistik från en vägg formler till ett verktyg för att inte bli lurad.
Vanliga frågor
- Vad är skillnaden mellan medelvärde, median och typvärde?
- Medelvärdet är det aritmetiska genomsnittet, summan av alla värden dividerad med hur många det finns. Medianen är det mittersta värdet när datan är sorterad, med hälften ovanför och hälften under. Typvärdet är värdet som dyker upp oftast. De stämmer överens för symmetrisk data men drar isär när datan är skev, vilket är precis när valet spelar roll.
- När ska jag använda medianen i stället för medelvärdet?
- Använd medianen när några extrema värden skulle dra medelvärdet någonstans orepresentativt. Inkomster, huspriser och svarstider är klassiska fall. En miljardär i ett rum av lärare gör medelinkomsten vilseledande, men medianen beskriver fortfarande en typisk person i rummet.
- Vad mäter standardavvikelsen faktiskt?
- Standardavvikelsen mäter hur utspridd datan är kring medelvärdet, i samma enheter som datan själv. En liten standardavvikelse betyder att värden klustrar tätt nära genomsnittet. En stor betyder att de sprids vitt. Den svarar på frågan medelvärdet inte kan: hur typiskt är typiskt.
- Vad är skillnaden mellan korrelation och kausalitet?
- Korrelation betyder att två saker tenderar att röra sig tillsammans. Kausalitet betyder att den ena faktiskt får den andra att hända. Glassförsäljning och drunkning stiger tillsammans, men ingen av dem orsakar den andra: sommarvärme driver båda. Korrelation är en ledtråd värd att undersöka, aldrig bevis på egen hand.
- Varför är ett större stickprov bättre?
- Större stickprov krymper slumpbrus, så resultatet är mer sannolikt att återspegla den verkliga populationen. Fällan: storlek kan inte laga ett skevt stickprov. En opinionsundersökning av en miljon personer som alla läser samma webbplats är fortfarande skev. Representativitet spelar större roll än rå storlek, och först därefter skärper storlek skattningen.