Förstå sannolikhet intuitivt (varför "en på miljonen" ljuger för dig)
Prognosen säger 30 procents chans till regn. Ett medicinskt test för en sällsynt sjukdom kommer tillbaka positivt. Lotterijackpotten ligger på 200 miljoner kronor och din kollega köper en bunt lotter. I var och en av de här situationerna har magkänslan en åsikt, och magkänslan har vanligtvis fel. Sannolikhet är platsen där matematisk intuition sviker flest människor oftast, även smarta, även människor som undervisar ämnet. Talen är inte svåra. Instinkterna runt dem är vilseledande.
Den här artikeln är bilden av vad en sannolikhet faktiskt är, varför bekanta intuitioner brister, och hur du lagar dem. Matten är enkel. Tänkeskiftet är den svårare delen, och det lönar sig i nästan varje område en människa någonsin rör: väder, medicin, sport, finans, spel, maskininlärning, till och med vanliga riskbeslut om att flyga kontra att köra.
Den enda idén: att räkna
Strippa bort allt annat, och sannolikhet är räkning. För att hitta sannolikheten för en händelse räknar du utfallen där händelsen sker, och dividerar sedan med det totala antalet utfall du började med. Det är hela definitionen. Varje formel i kapitlet är ett noggrant sätt att räkna.
Kasta en rättvis sexsidig tärning. Chansen att få en 4 är ett utfall (en 4) delat med sex utfall totalt (1 till 6), vilket är 1/6. Chansen att få ett jämnt tal är tre utfall (2, 4, 6) delat med sex totalt, vilket är 3/6, eller 1/2. Chansen att få ett tal större än 7 är noll utfall delat med sex, vilket är 0, för att inget sådant utfall finns.
Om bilden låter som bråk är det för att den är det. Som vi visade i artikeln om bråk är ett bråk en division som väntar på att hända. Sannolikhet är precis samma idé tillämpad på utfall: de matchande över alla. Hela ämnet är bråk hela vägen ner.
Fällan är att "räkna utfall" blir svårare när situationerna blir mer komplicerade. Resten av kapitlet, permutationer, kombinationer, betingad sannolikhet, Bayes sats, är bara noggrann bokföring för hur man räknar väl när situationen inte är så enkel som en tärning.
Oberoende händelser: när sannolikheter multipliceras
Anta att du singlar en rättvis slant två gånger. Vad är sannolikheten för krona två gånger i rad?
Många gissar 1/2 plus 1/2, vilket är 1, och det kan uppenbarligen inte stämma. En del svarar 1/2, vilket känns säkrare men också är fel. Rätt svar är , och skälet är värt att tänka på en stund, för det är draget som bryter intuitionen för de flesta nybörjare.
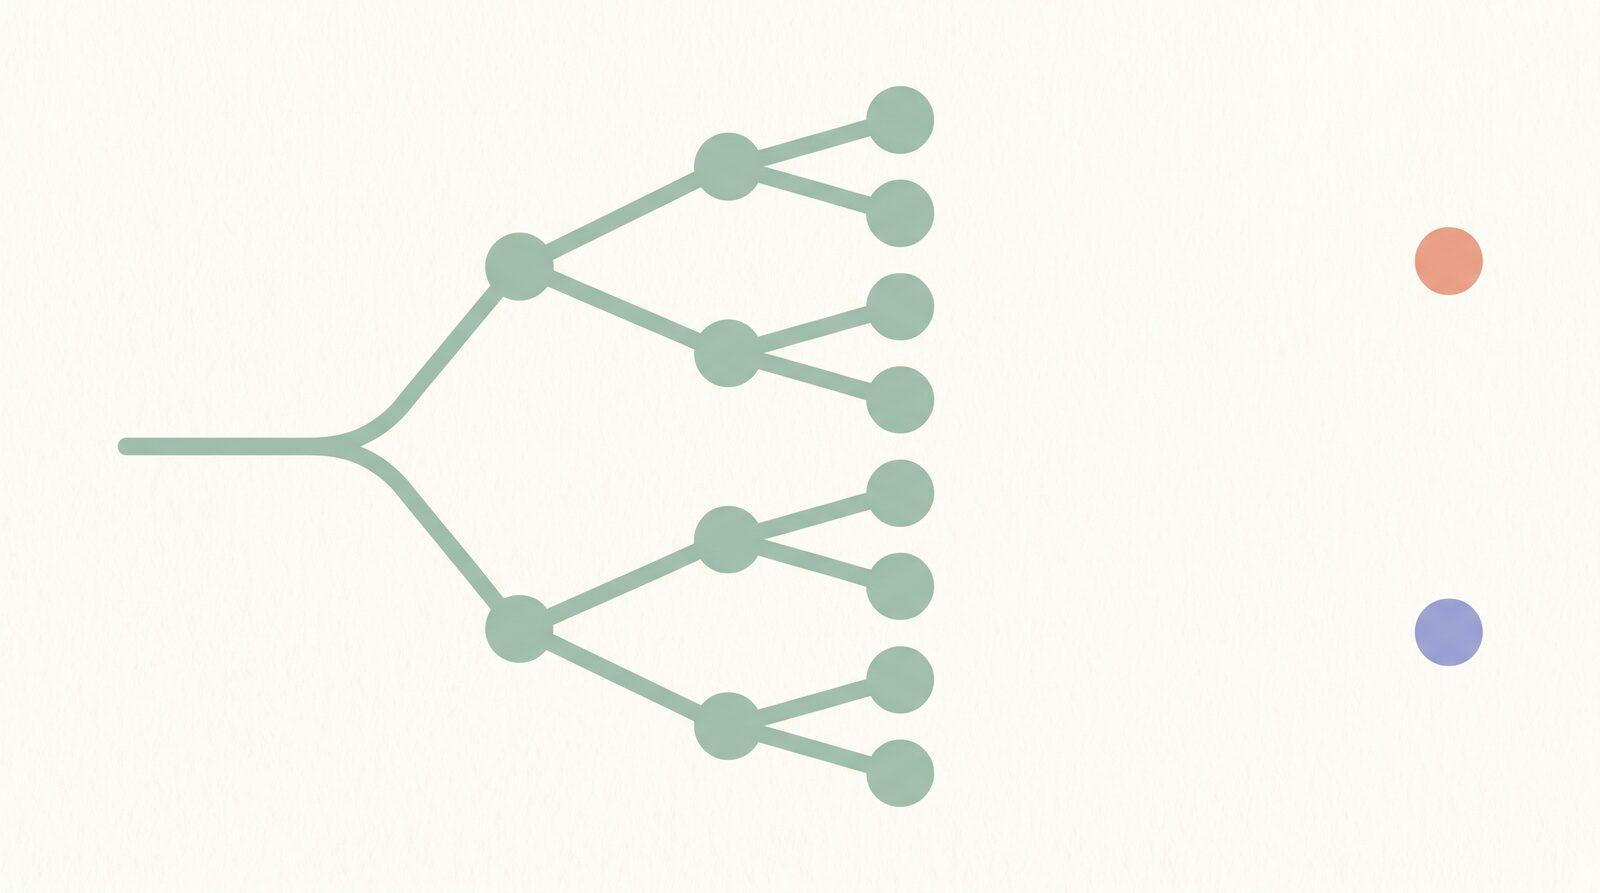
När två händelser är oberoende (utfallet av den ena inte påverkar utfallet av den andra) är sannolikheten att båda sker produkten av deras enskilda sannolikheter. Varför multiplicera? Lista varje möjligt utfall av två slantsinglingar: KK, KM, MK, MM. Det finns fyra totalt, och bara ett av dem är KK, så svaret är 1/4. Multiplikationen är bara en genväg för den uppräkningen.
Samma idé förklarar varför långa sviter är så sällsynta. Chansen att singla krona tio gånger i rad är (1/2) upphöjt till tionde, vilket är ungefär 1 på 1 024. Inte omöjligt, men inte vanligt. Och chansen att gissa en slumpmässig sexsiffrig pinkod rätt är (1/10) upphöjt till sjätte, vilket är en på miljonen. Det är den sortens "en på miljonen" som är verklig. Vi ska strax möta flera som inte är det.
När händelser inte är oberoende
Oberoende är antagandet som bryter fler sannolikhetsproblem än något annat. Om du drar två kort från en lek utan att lägga tillbaka det första är sannolikheten för det andra kortet inte densamma som för det första, för leken har ändrats. Det finns 52 kort och 4 ess, så sannolikheten att dra ett ess först är 4/52. Efter att du dragit ett ess har leken 51 kort och 3 ess, så sannolikheten för ett andra ess är 3/51. Sannolikheten för två ess i rad är därför 4/52 gånger 3/51, ungefär 0,45 procent.
Det här är betingad sannolikhet: sannolikheten för en händelse givet att en annan redan har skett. Den skrivs , och det är vad det mesta verkliga resonemanget faktiskt vill ha. "Vad är chansen att det regnar i morgon?" är ett tal. "Vad är chansen att det regnar i morgon givet att radarn visar en stormcell över staden?" är ett annat, mycket högre tal. Den nya informationen arrangerar om räkningen av relevanta utfall.
De flesta "paradoxer" i sannolikhet är betingade sannolikhetsproblem med betingningen tyst gömd. Nysta upp betingningen, och paradoxen brukar försvinna.
Födelsedagsparadoxen
Här är en fråga som fångar nästan alla. I ett rum med 23 personer, vad är sannolikheten att minst två av dem har samma födelsedag?
Det intuitiva svaret är litet, för det finns 365 dagar och bara 23 personer. Det faktiska svaret är precis över 50 procent. Med 50 personer i rummet klättrar det till 97 procent. Med 70 personer är det över 99,9 procent. Det här är födelsedagsparadoxen, och det är inte ett fel i universum. Det är ett fel i hur intuitionen räknar.
Fällan är att du inte frågar "vad är sannolikheten att någon har min födelsedag." Du frågar "vad är sannolikheten att vilka två personer som helst delar." Med 23 personer finns det 23 över 2, vilket är 253 olika par personer, och varje par har en liten chans att matcha. Det är många chanser, och små sannolikheter summerar snabbare än magkänslan väntar sig.
Lärdomen är allmän. När antalet tillfällen för en händelse växer kvadratiskt (varje par, varje interaktion) blir sällsynta händelser vanliga snabbt. En chans på 1 på 365 per par blir en chans bättre än jämnt totalt när det finns 253 par.
Basfrekvenser och tricket med en på miljonen
Ett medicinskt test är "99 procent träffsäkert" för en sjukdom som drabbar 1 på 10 000 personer. Du testar positivt. Vad är sannolikheten att du faktiskt har sjukdomen?
Många, inklusive läkare, gissar någonstans runt 99 procent. Rätt svar ligger närmare 1 procent.
Här är varför. Föreställ dig 10 000 slumpmässiga personer. Ungefär 1 av dem har sjukdomen, och testet kommer troligen att fånga dem. De andra 9 999 har den inte, men ett test som är 99 procent träffsäkert felklassificerar 1 procent av friska som positiva, vilket är ungefär 100 falskt positiva. Så av varje 101 positiva resultat är 100 falsklarm och bara 1 är äkta. Sannolikheten att du faktiskt har sjukdomen, givet ett positivt test, är ungefär 1 på 101, eller cirka 1 procent.
Det här är basfrekvensfelslutet. När den underliggande händelsen är sällsynt (låg basfrekvens) ger även ett mycket träffsäkert test mestadels falskt positiva. De flesta hoppar över basfrekvensen helt och tänker bara på testets träffsäkerhet, vilket leder dem till ett tal som är fel med två storleksordningar.
Lärdomen generaliserar långt bortom medicin. "1 på miljonen" är ett tal som alltid ska utlösa en följdfråga: 1 på miljonen av vad? 1 på miljonen per dag, per år, per försök, per person? En daglig händelse på 1 på miljonen händer ungefär 365 gånger om året om världen har tillräckligt många dagar, och ungefär 8 miljarder gånger om året om världen har tillräckligt många människor. När du tar med befolkningen och tidsfönstret slutar "1 på miljonen" vanligtvis att kännas sällsynt. Rubriken som öppnar den här artikeln fungerar på samma sätt: de flesta "mirakel" i nyheterna är händelser på 1 på miljonen som hade flera miljarder chanser att hända.
Spelarens felslut
Ett roulettehjul har kommit upp rött åtta gånger i rad. Visst är svart försenat?
Det är det inte. Hjulet har inget minne. Sannolikheten för svart på nästa snurr är densamma som den var på det första. Det här är spelarens felslut, tron att tidigare oberoende händelser ändrar oddsen för framtida. Det gör de inte.
Spegelversionen av samma misstag är heta handen-felslutet: tron att en spelare som just gjort flera skott i rad är mer benägen att göra nästa. För slantsingling och roulette är det tydligt fel, för apparaten har inget minne. För mänsklig prestation är bilden genuint mer komplicerad (verklig skicklighet finns, verklig momentum finns ibland), men den underliggande lärdomen står: de flesta sviter är mönstermatchning av ett djur som utvecklades till att hitta mönster oavsett om de fanns där eller inte.
Där sannolikhet dyker upp
När du har räkningsramen dyker sannolikhet upp överallt.
Väderprognoser: 30 procents chans till regn betyder att det, över en stor mängd liknande atmosfäriska förhållanden, regnade på ungefär 30 procent av dem. Det är ingen garanti, och det är inte en slantsingling.
Medicin: varje test, screening och riskpoäng involverar basfrekvenstricket ovan. Ett "positivt" test betyder mycket olika saker för vanliga och sällsynta tillstånd, och "99 procent träffsäkert" utan en basfrekvens är nästan meningslöst.
Försäkring och finans: varje premie, förväntad avkastning och riskmodell är ett viktat medelvärde över möjliga utfall. Matten är bara sannolikhet multiplicerad med utbetalning, summerad över alla möjliga scenarier.
Standardiserade test: SAT, ACT, GRE, AP Statistics och GCSE innehåller alla sannolikhetsfrågor, och många av dem är betingade sannolikhetsproblem i förklädnad. Som vi noterade i vår SAT-förberedelseguide är tricket inte räkningen, det är att känna igen strukturen.
Maskininlärning: varje klassificerare producerar sannolikheter, och varje mått (precision, recall, ROC-kurvor) är en noggrann tillämpning av betingad sannolikhet och basfrekvenser. Basfrekvensfelslutet slår till här igen: en modell som är 99 procent träffsäker på en sällsynt händelse kan fortfarande vara oanvändbar i produktion.
Uppskatta odds snabbt
De flesta sannolikhetsfrågor i verkliga livet behöver inget exakt svar. De behöver en snabb, försvarbar uppskattning. Här är dragen som tar dig merparten av vägen.
Översätt till ett bråk först, sedan till ett procent eller decimal. "1 på 100" är 1/100 är 1 procent är 0,01. Som vi visade i huvudräknetrick är flyt i de här omvandlingarna en av de färdigheter med högst hävstång du kan bygga, för nästan varje sannolikhetsproblem slutar med en översättning mellan notationer.
Leta alltid efter basfrekvensen, särskilt när någon räcker dig ett träffsäkerhetstal för en sällsynt händelse. Om basfrekvensen är liten är träffsäkerhetstalet vilseledande.
Kolla oberoendet noga. Två händelser ser oberoende ut när den ena i själva verket driver den andra (testresultat inom samma patient, aktier inom samma sektor, elever i samma klass). När händelser delar en dold orsak ger multiplikation av sannolikheterna ett svar som är för litet eller för stort.
Stresstesta "1 på miljonen". Fråga: per vad, över hur många människor, under hur lång tid? De flesta "sällsynta" händelser är inte sällsynta när du räknar tillfällena.
Hur övning bygger reflexen
Sannolikhet är ämnet där mönsterigenkänning spelar störst roll, för samma problem kommer i tjugo olika kostymer. Eleven som har sett och sett om strukturerna (oberoende kontra beroende, med återläggning kontra utan, betingad kontra gemensam) börjar spotta strukturen inom sekunder, och räkningen faller ur den igenkänningen.
Math Zens bucket-progression passar rent mot hur ämnet faktiskt vill läras. De tidigaste buckets täcker att räkna utfall för enkla experiment (tärningar, kort, slantar). De mellersta buckets övar multiplikationsregeln och additionsregeln för unioner, med blandad övning så att hjärnan lär sig identifiera situationen i stället för att blint tillämpa en formel. De senare buckets arbetar med betingad sannolikhet, väntevärde, och de klassiska pussel (födelsedagsparadoxen, Monty Hall, basfrekvensproblem). Eftersom övningen är kort och utspridd får du upprepade chanser att känna igen strukturen, vilket är det som till slut förvandlar reglerna till reflexer.
Sammanfattning
Sannolikhet är en idé: räkna utfallen som matchar, dividera med alla utfall som finns, och var ärlig om huruvida händelserna du räknar verkligen är oberoende. "Paradoxerna" är bara situationer där magkänslan räknar något annat än matten. Multiplicera när händelser är oberoende. Addera när du vill ha chansen för antingen (dra ifrån överlappet, så att du inte dubbelräknar). Betinga när ny information kommer. Leta alltid efter basfrekvensen, särskilt när någon räcker dig en "1 på miljonen."
När du börjar fråga "1 på miljonen av vad, per vad, över hur många?" slutar vardagsvärlden att kännas slumpmässig på samma sätt. Lotteriet blir en liten förväntad förlust med sällsynta jackpottar. Det medicinska testet blir en fråga om basfrekvenser. Den heta sviten blir en slump som hjärnan klär i kausalitet. Talen ändras inte, men sättet du läser dem på gör det, och den förändringen lönar sig för alltid.