분산과 표준편차의 차이: 같은 데이터로 끝까지 계산하기
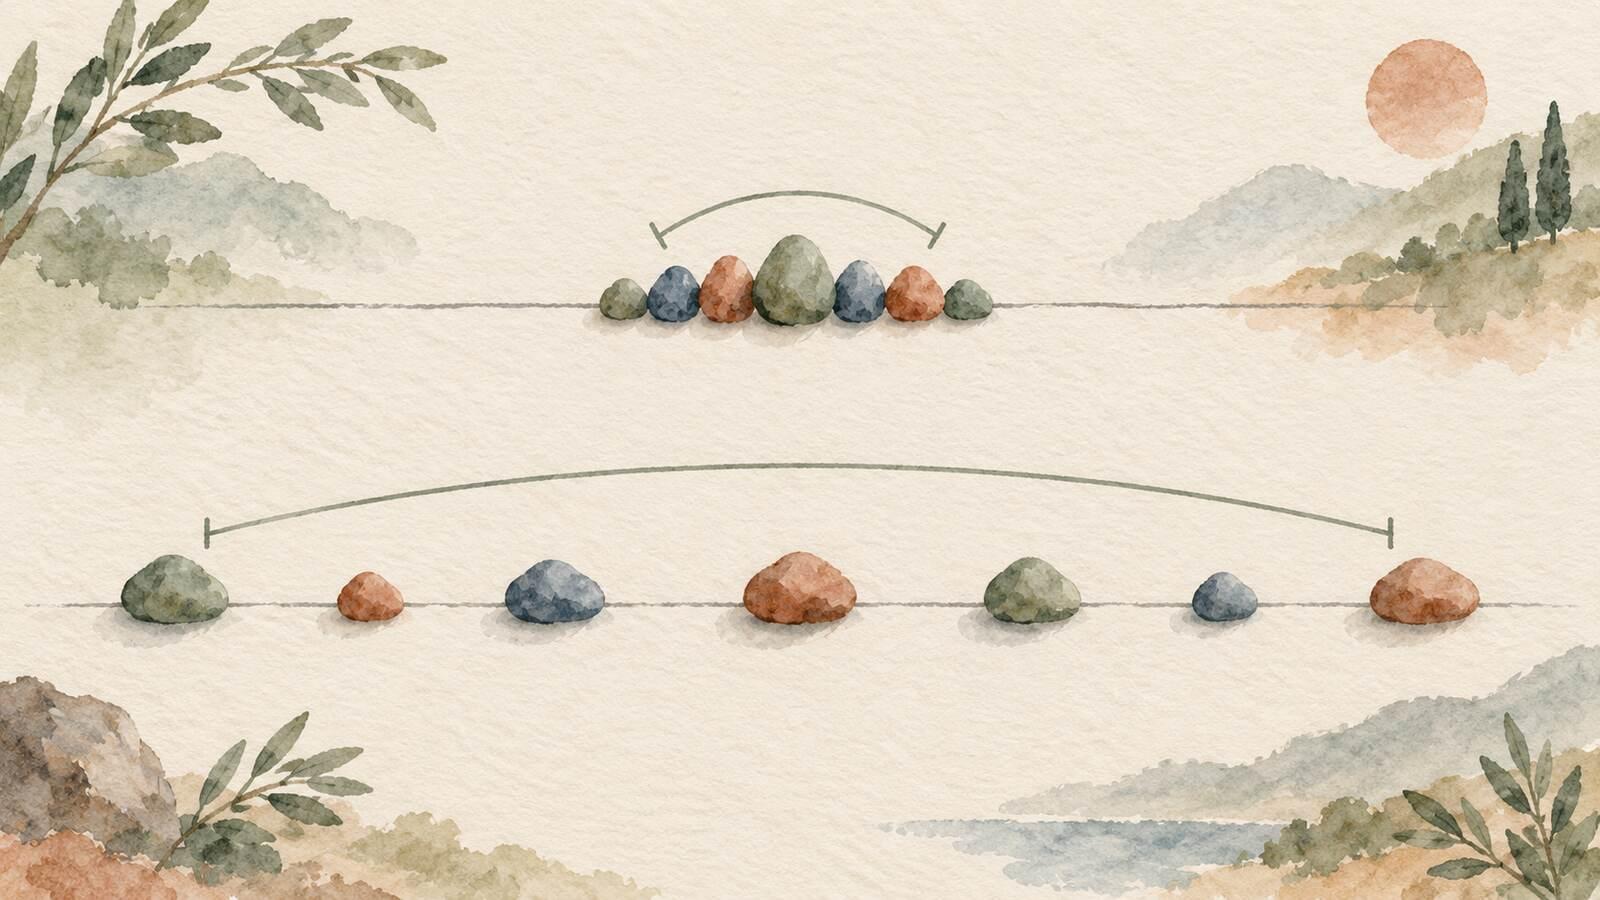
두 집단이 퍼즐을 푸는 데 걸리는 시간은 평균 4분으로 같아요. 첫 번째 집단은 모두 4분에 끝나요. 두 번째 집단은 절반이 2분, 나머지 절반이 6분에 끝내죠. 평균은 같지만 두 번째 집단의 시간은 더 넓게 퍼져 있어요. 분산과 표준편차는 이 차이를 숫자로 나타내요.
둘 다 평균 주위의 산포라는 같은 특성을 재지만, 표현하는 척도가 달라요. 분산은 원래 단위를 제곱해서 쓰고, 표준편차는 분산의 제곱근을 취해 원래 단위로 돌아와요. 데이터가 분 단위라면 분산은 분의 제곱, 표준편차는 분이에요. 데이터가 모집단 전체인지 일부를 뽑은 표본인지에 따라 계산 방법도 달라져요.
이 글에서는 한 데이터셋을 처음부터 끝까지 계산해요. 평균, 중앙값, 분포에 관한 큰 그림이 먼저 필요하다면 통계 입문 글을 읽어 보세요.
평균에서 얼마나 벗어났는지부터 구해요
퍼즐을 푼 여덟 번의 시도가 각각 다음만큼 걸렸다고 해 볼게요. 단위는 분이에요.
합은 분이므로 평균은 분이에요. 다음에는 각 시간에서 5를 빼요. 편차는 다음과 같아요.
음수는 평균보다 빠르다는 뜻이고 양수는 느리다는 뜻이에요. 산술평균에서 구한 편차의 합은 언제나 0이에요. 따라서 편차를 그대로 평균하면 값들이 크게 다른 데이터셋도 산포가 0이라고 나오죠. 도움이 되지 않아요. 편차를 각각 제곱하면 음수가 사라지고, 평균에서 멀리 떨어진 값일수록 영향이 커져요. NIST의 산포 척도 설명도 이 점을 다뤄요.
여덟 편차를 제곱하면 다음과 같아요.
| 시간, 분 | 5분에서의 편차, 분 | 편차의 제곱, 분² |
|---|---|---|
| 2 | -3 | 9 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 4 | -1 | 1 |
| 5 | 0 | 0 |
| 5 | 0 | 0 |
| 7 | 2 | 4 |
| 9 | 4 | 16 |
마지막 열의 합은 제곱분이에요. 이 합에서 두 통계량의 계산이 시작돼요. 여기서부터 관측된 시간은 변하지 않아요. 무엇으로 나눌지는 여덟 시간이 무엇을 대표하는지에 달려 있어요.
여덟 값이 모집단 전체라면
여덟 번의 시도가 관심 있는 작은 대회에서 일어난 모든 시도라고 가정해요. 관측하지 않은 더 큰 집단을 추정하는 게 아니라, 완전한 집단을 묘사하는 거예요. 제곱한 편차의 합을 값의 개수인 로 나눠요.
이것이 모분산이고, 기호는 예요. 그다음 제곱근을 취해요.
이 값은 모표준편차예요. 제곱근을 취한다고 앞의 계산이 절댓값 거리의 평균으로 바뀌는 건 아니에요. 편차를 이미 제곱하고 합친 뒤에 단위와 수치 척도를 되돌리는 거예요. OpenStax의 산포 설명도 같은 모집단 기호와 분모를 사용해요.
여기서 2분은 무슨 뜻일까요? 평균인 5분을 중심으로 시간들이 얼마나 퍼져 있는지 분 단위로 나타낸 값이에요. 모든 결과가 5분에서 2분 이내에 있다는 뜻은 아니에요. 이 목록에는 2분과 9분도 있죠. 또 일정한 비율의 값이 그 범위에 반드시 들어간다는 뜻도 아니에요. 그런 백분율 규칙을 쓰려면 표준편차 하나만 계산하는 게 아니라 분포에 대한 가정도 필요해요.
여덟 값이 표본이라면
이제 같은 여덟 시간이 훨씬 더 큰 시도 집합에서 선택됐고, 그 모집단이 얼마나 변동하는지 추정하고 싶다고 가정해요. 관측된 평균 5분 자체도 표본에서 계산한 값이에요. 일반적인 표본분산은 분모로 을 써요.
표본표준편차는 이렇게 구해요.
같은 합 를 8이 아니라 7로 나누므로 모집단 계산보다 결과가 조금 커요. 관대한 공식과 엄격한 공식 중 하나를 고르는 게 아니에요. 여덟 값을 완전한 집단으로 설명할지, 관측된 여덟 값으로 더 큰 집단의 산포를 추정할지, 두 가지 질문이 다른 거예요. OpenStax의 데이터 과학 교재에는 두 공식과 단위의 차이가 함께 나와 있어요.
왜 7일까요? 표본평균을 바로 이 관측값에 맞춰 계산했기 때문에 표본 안에서의 편차는 알 수 없는 모집단 평균에서의 편차보다 작아 보이기 쉬워요. 일반적인 표본추출 조건에서 을 사용하면 분산을 낮게 추정하는 경향이 보정돼요. 기억하는 방법으로, 표본평균을 고정하면 일곱 편차는 자유롭게 달라질 수 있지만 마지막 하나는 총합이 0이 되도록 정해져요. 더 깊은 통계적 이유는 표본을 반복해 뽑았을 때 표본분산이 어떻게 움직이는지와 관련돼요. 여기서는 나누기 전에 모집단인지 표본인지 확인한다는 실용적인 규칙이면 충분해요.
어떤 숫자를 보고해야 할까요?
계산에 제곱된 형태의 산포가 필요하거나 분산으로 정의된 다른 통계 공식에 넣을 때는 분산을 써요. 독자가 산포를 원래 측정값과 비교하도록 하려면 표준편차를 쓰세요. “표준편차 약 2.14분”은 평균 5분과 바로 비교할 수 있어요. “분산 약 4.57제곱분”도 수학적으로 맞지만 떠올리기는 더 어려워요.
어느 계산을 썼는지 꼭 표시하세요. “SD = 2”와 “SD = 2.14”는 둘 다 같은 여덟 시간에서 나왔어요. 모집단인지 표본인지 밝히지 않으면 독자는 왜 값이 다른지 알 수 없어요. 계산기에 와 가 있다면 서로 바꿔 누를 수 있는 버튼이 아니에요. 완전한 모집단을 설명할 때는 , 표본을 계산할 때는 를 선택해요.
단위도 중요해요. 데이터가 센티미터라면 분산은 이고 표준편차는 센티미터예요. 값이 단위 없는 점수라면 두 결과 모두 단위가 없어요. 두 수를 모두 “점” 또는 모두 “제곱점”이라고 부르면 제곱근을 취하면서 무엇이 바뀌었는지 가려져요.
범위만 쓰면 안 될까요?
시간의 범위는 분이에요. 이 값은 최댓값과 최솟값 사이의 거리만 알려 주고, 그 사이의 여섯 값은 말해 주지 않아요. 2와 9는 그대로 두고 가운데 값 하나를 바꿔도 범위는 7이지만 전체 패턴은 바뀌어요. 분산과 표준편차는 모든 관측값을 사용하므로 가운데 값의 변화도 결과에 반영돼요.
그 장점에는 한계도 있어요. 제곱 때문에 멀리 떨어진 값의 영향이 커져요. 이 데이터에서는 9분짜리 시도 하나가 제곱분을 차지하고, 전체 합은 제곱분이에요. 큰 이탈이 중요할 때는 장점이지만, 산포 숫자 하나를 해석하기 전에 데이터를 직접 봐야 하는 이유이기도 해요. NIST도 산포 척도를 비교하면서 큰 편차가 더 강하게 반영된다고 설명해요. 표준편차가 있다고 해서 특이한 값이나 비대칭 분포를 놓쳐서는 안 돼요.
직관을 위해 평균이 모두 4인 네 값짜리 두 집합, 와 을 비교해 봐요. 첫 번째는 제곱한 편차가 모두 0이고 표준편차도 0이에요. 두 번째는 각 값이 4에서 2만큼 떨어져 있으므로 제곱한 편차가 각각 4예요. 둘 다 완전한 모집단이라고 보면 두 번째의 분산은 4, 표준편차는 2예요. 평균이 같다는 사실만으로는 이 차이가 보이지 않아요.
흔한 계산 실수
데이터가 무엇인지 결정하기 전에 나누기. 계산 위에 “모집단” 또는 “표본”이라고 쓰세요. 모집단에는 , 표본으로 모분산을 추정하는 일반적인 표본분산에는 을 써요. 둘을 혼동하면 둘 다 그럴듯한데 서로 다른 답이 나오기 쉬워요.
제곱근을 잊기. 제곱한 편차의 합을 분모로 나누면 분산이에요. 표준편차는 그 숫자의 제곱근이에요. 문제에서 둘 다 물으면 둘 다 답하세요.
단위를 빼먹기. 제곱한 편차의 합과 분산은 제곱 단위를 쓰고, 표준편차는 원래 단위를 써요. 계산이 맞는지 빨리 점검할 수 있어요.
절댓값 거리의 평균이라고 부르기. 그건 평균절대편차라는 다른 척도예요. 표준편차는 먼저 제곱하고, 모집단 또는 표본에 맞는 분모로 나눈 다음 제곱근을 취해요. 보통 서로 다른 값이 나와요.
매 행을 반올림하기. 제곱한 편차와 분수는 가능한 한 정확하게 유지하세요. 이 데이터에서는 반올림한 분산의 제곱근보다 에서 바로 구한 표본표준편차가 더 정확해요.
표를 베끼지 않고 연습하기
를 네 값 모두가 완전한 모집단이라고 보고 풀어 보세요. 평균은 , 편차는 이므로 제곱한 편차의 합은 이에요. 모분산은 제곱 단위이고 모표준편차는 원래 단위예요. 이 네 값이 표본이라면 3으로 나눠요. 표본분산은 , 표본표준편차는 이에요.
마지막 값만 5에서 9로 바꿔 보세요. 계산하기 전에 산포가 증가할지 예측해요. 증가하지만 그래도 처음부터 다시 계산하세요. 평균도 바뀌므로 이전 편차 표에서 한 줄만 고칠 수는 없어요. 평균과 산포를 함께 계산해야 하는 이유를 확인하는 연습이에요.
표 하나를 직접 채울 수 있게 되면 Math Zen의 통계 연습이 도움이 돼요. 평균을 찾고, 맞는 분모를 고르고, 답의 단위가 말이 되는지 확인해 보세요. 표본과 모집단의 구분이 여전히 추상적으로 느껴진다면 확률 가이드에서 표본으로 더 넓은 결과 집합을 추론하는 이유를 설명해요.
자주 묻는 질문
분산은 항상 표준편차보다 큰가요?
아니에요. 단위가 다르므로 숫자 크기를 직접 비교하는 건 보통 의미가 없어요. 숫자만 보면 선택한 단위에서 분산이 1보다 작을 때 제곱근이 분산보다 크고, 1보다 클 때는 제곱근이 더 작아요. 단위를 바꾸면 데이터 자체는 그대로여도 숫자의 크기 비교가 달라질 수 있어요.
표준편차가 음수일 수 있나요?
없어요. 제곱한 편차는 음수가 아니고, 그 합도 음수가 아니며, 표준편차에 사용하는 제곱근도 음수가 아니에요. 관측값이 전부 같을 때만 0이에요.
언제 n-1을 쓰나요?
같은 데이터에서 표본평균을 구하는 일반적인 표본분산과 표본표준편차에는 을 써요. 데이터가 설명하려는 모집단 전체라면 을 써요. 계산기를 누르기 전에 문제의 조건을 확인하세요.
차이를 가장 쉽게 기억하는 방법은 무엇인가요?
분산은 편차를 제곱해 측정한 산포예요. 표준편차는 그 분산의 제곱근이라서 데이터의 원래 단위로 돌아와요. 위 예시는 제곱한 편차의 합 제곱분에서 모분산 제곱분을 거쳐 모표준편차 분으로 이어져요.
자주 묻는 질문
- 분산과 표준편차는 어떻게 다른가요?
- 모집단의 분산은 평균에서 벗어난 정도를 제곱한 값들의 평균이에요. 표본의 분산은 제곱한 편차의 합을 n-1로 나눠요. 표준편차는 해당 분산의 제곱근이라서 원래 데이터와 같은 단위를 써요.
- 표본분산은 왜 n-1로 나누나요?
- 표본평균도 같은 데이터에서 추정해요. 이 표본으로 모분산을 추정할 때 제곱한 편차의 합을 n-1로 나누면 일반적으로 생기는 과소 추정 경향을 보정할 수 있어요. 완전한 모집단이라면 N으로 나눠요.
- 표준편차는 평균에서 떨어진 거리의 평균인가요?
- 아니에요. 편차를 제곱하고 알맞은 분모로 나눈 뒤 제곱근을 취해요. 절대 거리를 그대로 평균하면 평균절대편차라는 다른 값이 돼요. 둘 다 산포를 나타내지만 수치는 달라요.